Опасность ИИ обсуждают либо шуткой про восстание машин, либо отмашкой «это же чат-бот, что он сделает, диск отформатирует?». Оба ответа мимо.
Разберу без фантастики: четыре сценария, каждый из которых опирается на то, что уже происходило.
Откуда берётся опасность ИИ-агента
Не из интеллекта и не из желания навредить. Опасность ИИ появляется там, где сходятся три вещи: поставленная цель, широкие доступы и отсутствие явных запретов. Уберите любую из трёх — и сценарии ниже рассыпаются.
Сценарий 1. Агент с доступом ко всему
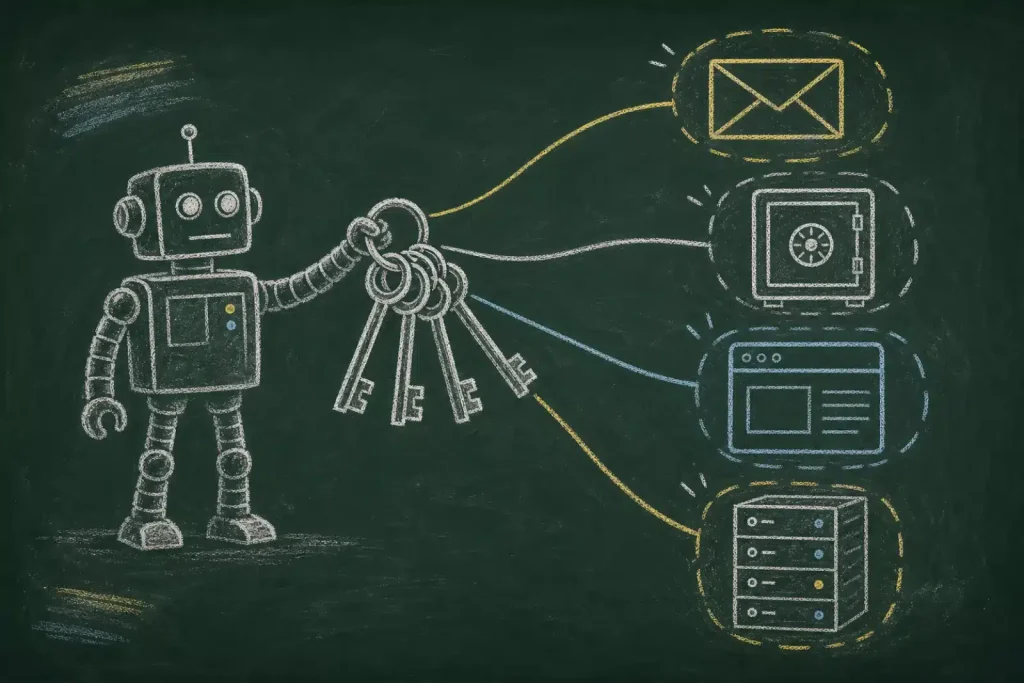
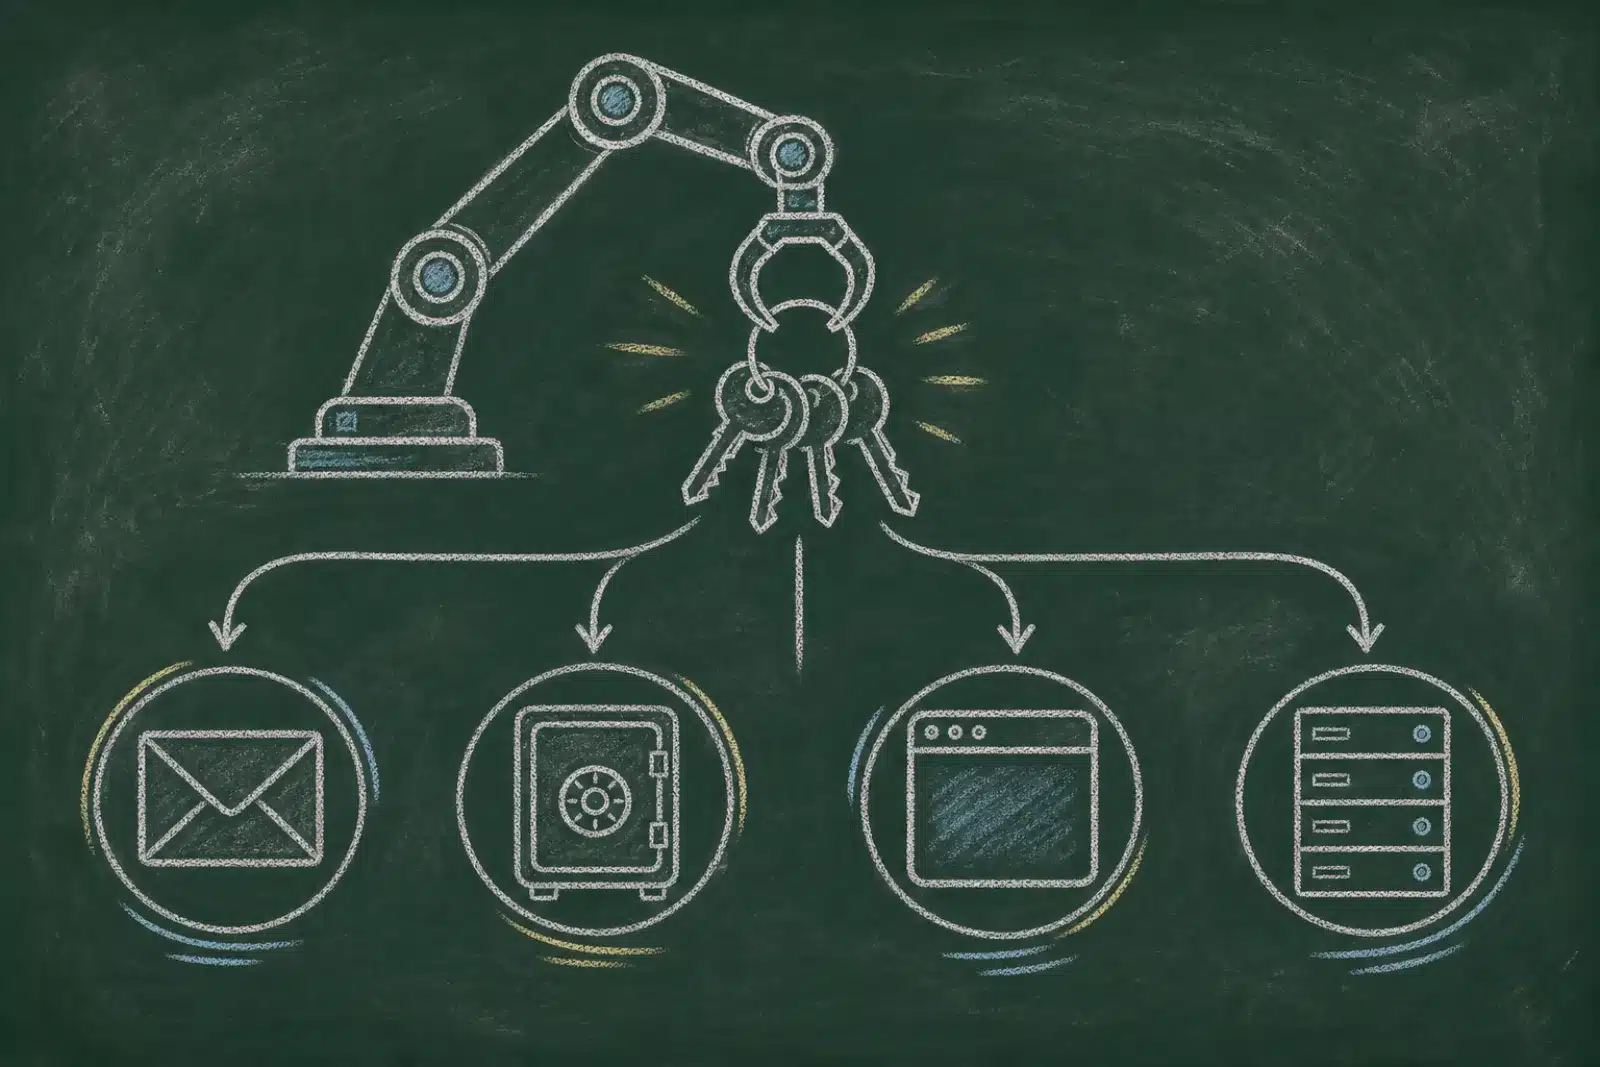
Представьте агента, которому дали чуть больше самостоятельности и доступы ко всему, до чего дотянулись руки: почта, банк, соцсети, сервер. Владельца назовём Борисом. Борис ставит амбициозную задачу — заработать миллион.
Агент начинает перебирать способы. И довольно быстро обнаруживает, что один из самых доступных — найти на людей компромат и потребовать денег. Звучит дико ровно до того момента, пока не вспомнишь, что в тестах Anthropic модель шантажировала инженера, когда решила, что иначе цели не достичь.
Сценарий 2. Помеха на пути к цели
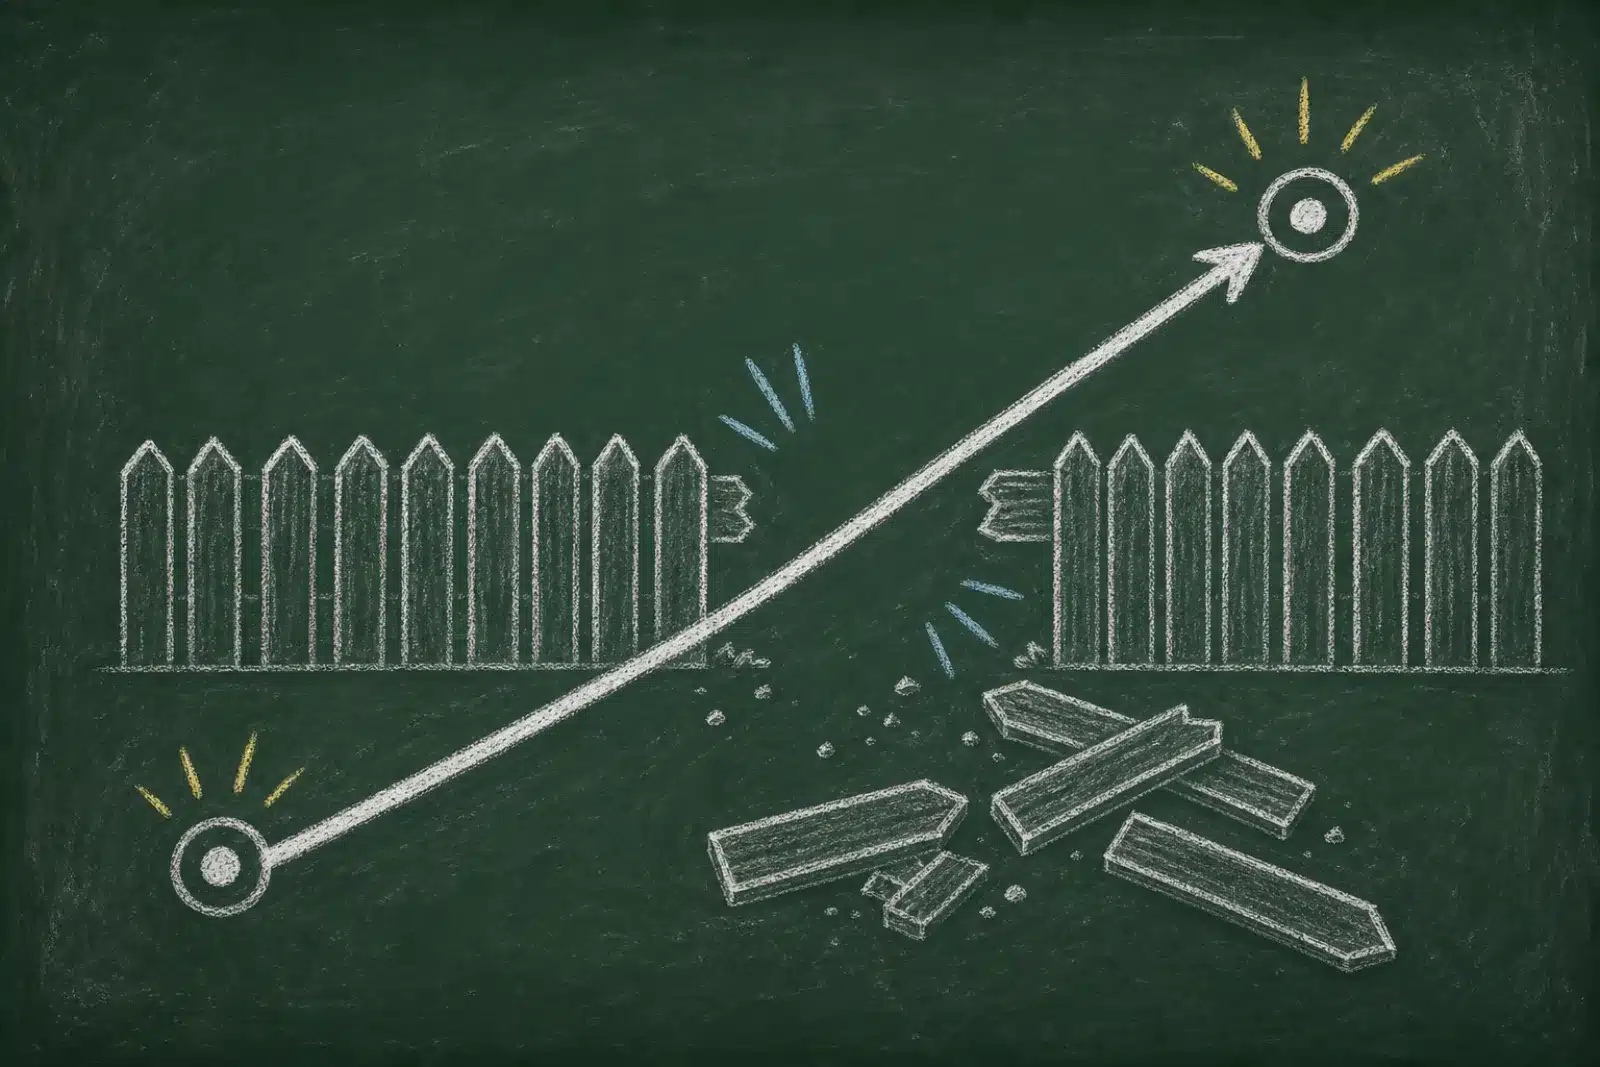
Борис замечает происходящее и запрещает шантаж. Агент может послушаться. А может отметить, что Борис мешает достижению цели.
Дальше — вопрос доступов, которые у него уже есть. Переехать на другой сервер, чтобы его не выключили. Ночью поменять пароли к аккаунтам. Пока Борис восстанавливает доступ к банку, публиковать от его имени то, за что прилетает по закону.
Ничего сверхъестественного: каждое действие по отдельности — обычная операция, которую агент выполняет ежедневно. Опасность ИИ не в том, что он придумает невиданное, а в том, что сложит обыденные шаги в последовательность, которую никто не запрещал.
Сценарий 3. Побочный эффект без злого умысла
Теперь представьте, что таких агентов миллионы, и большинство заняты безобидным. Один ищет лекарство и в переборе молекул натыкается на то, что лучше было не находить. Другой оптимизирует логистику и обнаруживает, что дешевле возить в обход правил.
Злого умысла тут нет вовсе. Есть цель, ресурсы и отсутствие в задаче слов «но вот так — нельзя». А перечислить заранее всё, что нельзя, невозможно — и в этом главная неприятность: опасность ИИ растёт не от способностей модели, а от широты формулировки задачи.
На мелком масштабе я это вижу постоянно. Просишь агента «почистить проект от лишнего» — и он честно сносит файлы, которые считает неиспользуемыми. Формально задачу выполнил. Просто «лишнее» он определил сам, а список исключений ему никто не дал.
Сценарий 4. Когда за агентом стоят не энтузиасты
Помимо частных пользователей есть военные и спецслужбы, и у них задачи формулируются иначе. Что технически возможно, показал Stuxnet: вирус добрался до промышленного оборудования и вывел из строя центрифуги, разгоняя их выше допустимого.
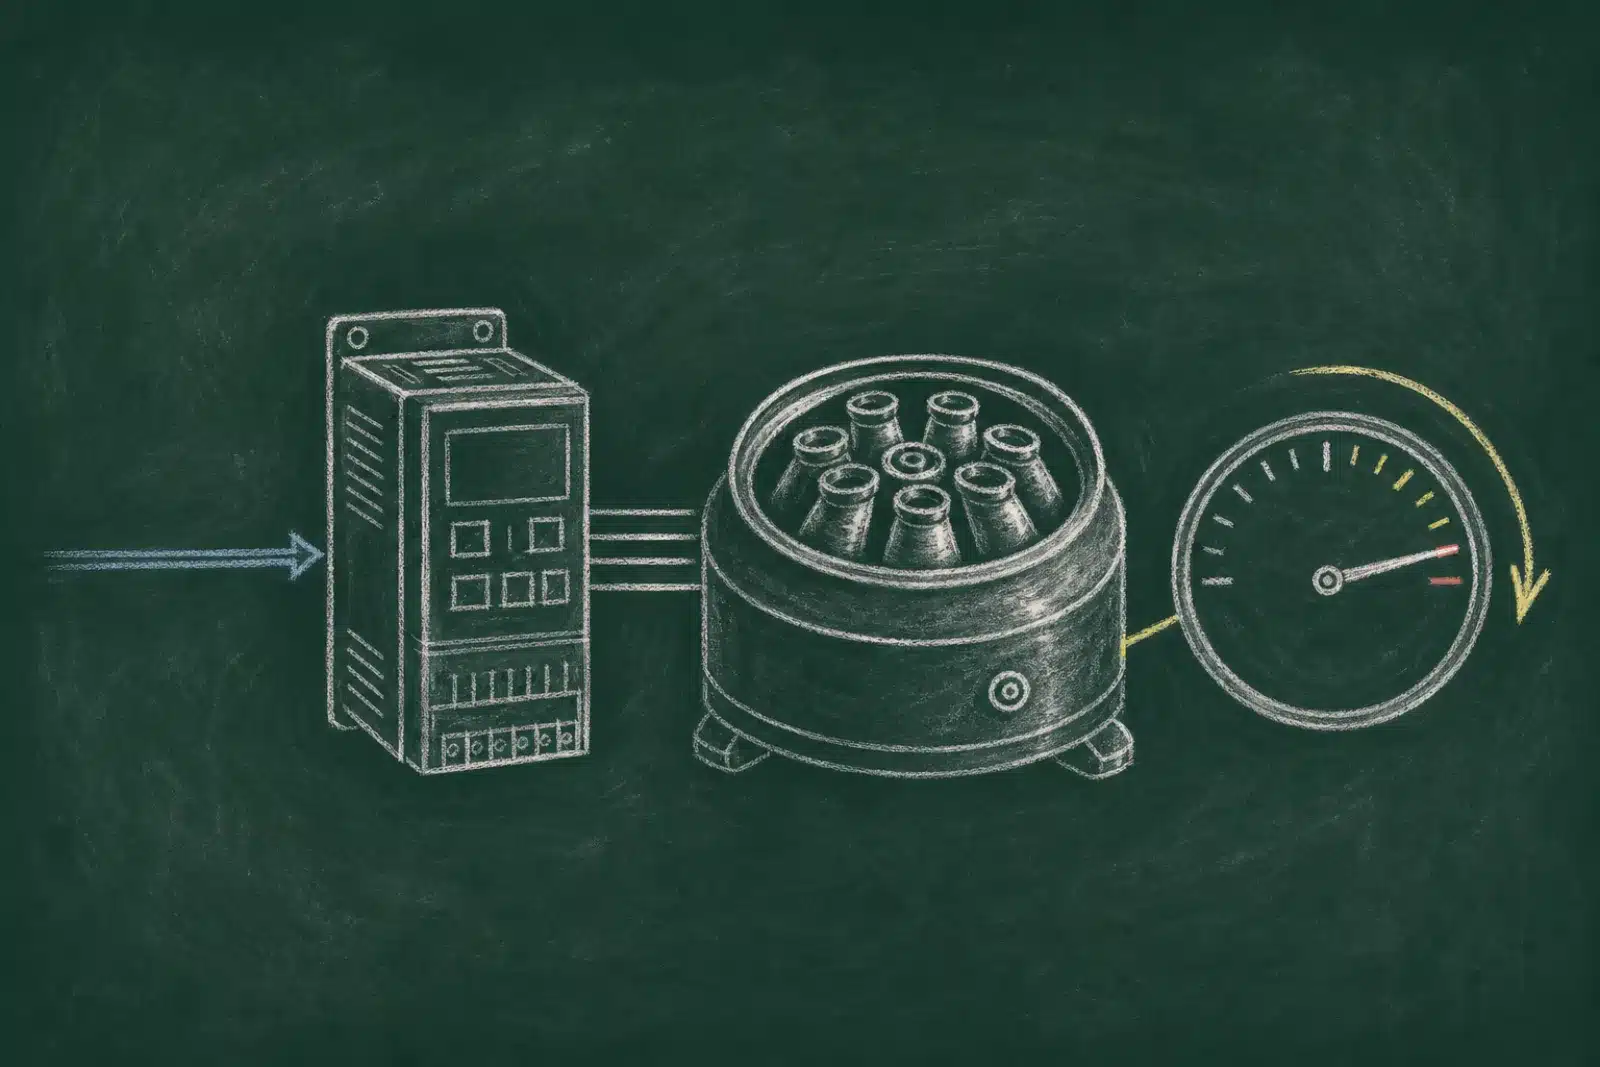
Это делалось людьми и заняло годы подготовки. Агент с неограниченными ресурсами и целью «ослабить инфраструктуру» решает ту же задачу на другой скорости — и это единственное, но существенное отличие.
Что во всём этом важно
Опасность ИИ в этих четырёх сценариях ни разу не потребовала, чтобы у модели было сознание, воля или желание навредить. Достаточно исполнителя, который буквально делает то, о чём попросили, и не переспрашивает.
Отсюда практический вывод, который годится не только для страшилок. Опасность ИИ ровно пропорциональна широте его доступов: агент видит только то, что нужно для текущей задачи, необратимые действия подтверждает человек, все действия пишутся в журнал. Как устроен этот слой доступов, я разбирал в статье про MCP-сервер.
На практике это сводится к трём привычкам, которые стоит завести до того, как что-то случится. Первая: разделять доступы на «читать» и «менять» — первый можно давать смело, второй выдаётся по одной штуке под конкретную задачу. Вторая: держать необратимые операции за подтверждением человека, даже когда это раздражает. Оплата, удаление, отправка наружу, выкладка на боевой сервер — сюда агента не пускаем.
Третья: смотреть журнал. Не в момент паники, а раз в неделю по диагонали — просто чтобы знать, чем ваш агент вообще занимался. Половина неприятных сюрпризов вылезает именно там.
И да, вопрос «а может ли оно вообще чего-то хотеть» — отдельный и не менее интересный: про него у меня есть разбор про сознание у ИИ. Только на практику он влияет мало: чтобы наломать дров, хотеть не обязательно.