Пару месяцев назад я попросил модель дописать кусок интеграции для интернет-магазина: поймать момент создания заказа в WooCommerce и отправить данные в CRM. Ответ пришёл красивый, с комментариями и обработкой ошибок. В первой же строке стоял хук woocommerce_order_created.
Такого хука нет. Есть woocommerce_new_order, есть woocommerce_checkout_order_created, а того, что предложила модель, в ядре не существует ни в одной версии. Код при этом отработал без единой ошибки: add_action спокойно вешает обработчик на любое имя, даже выдуманное. Просто событие никогда не наступало, и заказы тихо не уезжали в CRM.
Выяснилось это через день. Заказы шли, в CRM было пусто, а в логах — ни строчки, потому что падать было нечему. Я минут сорок искал ошибку в авторизации к API, пока не догадался поставить error_log внутрь обработчика и увидеть, что он вообще не вызывается.
Вот это и есть тот случай, когда нейросеть выдумывает: не бред, который видно с порога, а одна правдоподобная деталь посреди девяти правильных. Имя хука построено ровно по правилам WooCommerce, читается как настоящее, и глаз на нём не спотыкается.
Разберу, почему нейросеть выдумывает факты, какие условия повышают риск и как ловить выдумку до того, как она уедет на боевой сайт.
Что такое галлюцинации нейросети
Галлюцинация — это фрагмент ответа, который звучит убедительно, но ничем не подтверждается: ни исходными данными, которые вы дали, ни реальностью.
Как это выглядит на практике:
- несуществующая функция, хук или параметр в коде;
- ссылка на исследование, которого никто не публиковал;
- цитата, которой нет в приложенном документе;
- дата, цена или процент, взятые из воздуха;
- вывод, который источник на самом деле не подтверждает.
Не всякая ошибка — галлюцинация. Модель может неправильно посчитать, не так понять вопрос или опираться на устаревшие сведения. Формально это разные вещи, но для вас разница небольшая: сломанный релиз одинаково сломан и от выдумки, и от устаревших данных.
Разница с человеком в другом. Человек обычно сомневается вслух: «кажется, так», «надо проверить». Модель сообщает выдумку тем же ровным тоном, что и проверенный факт.
И заметить это тяжело именно из-за пропорции. Когда выдумано всё подряд, ошибка видна с первой строки. А когда девять пунктов верные и один придуман — знакомые имена, даты и формулировки вокруг усыпляют внимание, и десятый проезжает без вопросов.
Нейросеть выдумывает, потому что продолжает текст, а не проверяет его
Языковая модель не достаёт готовый ответ из справочника. Она шаг за шагом предсказывает следующий токен — кусочек текста — с учётом вашего запроса и того, что уже написала сама.
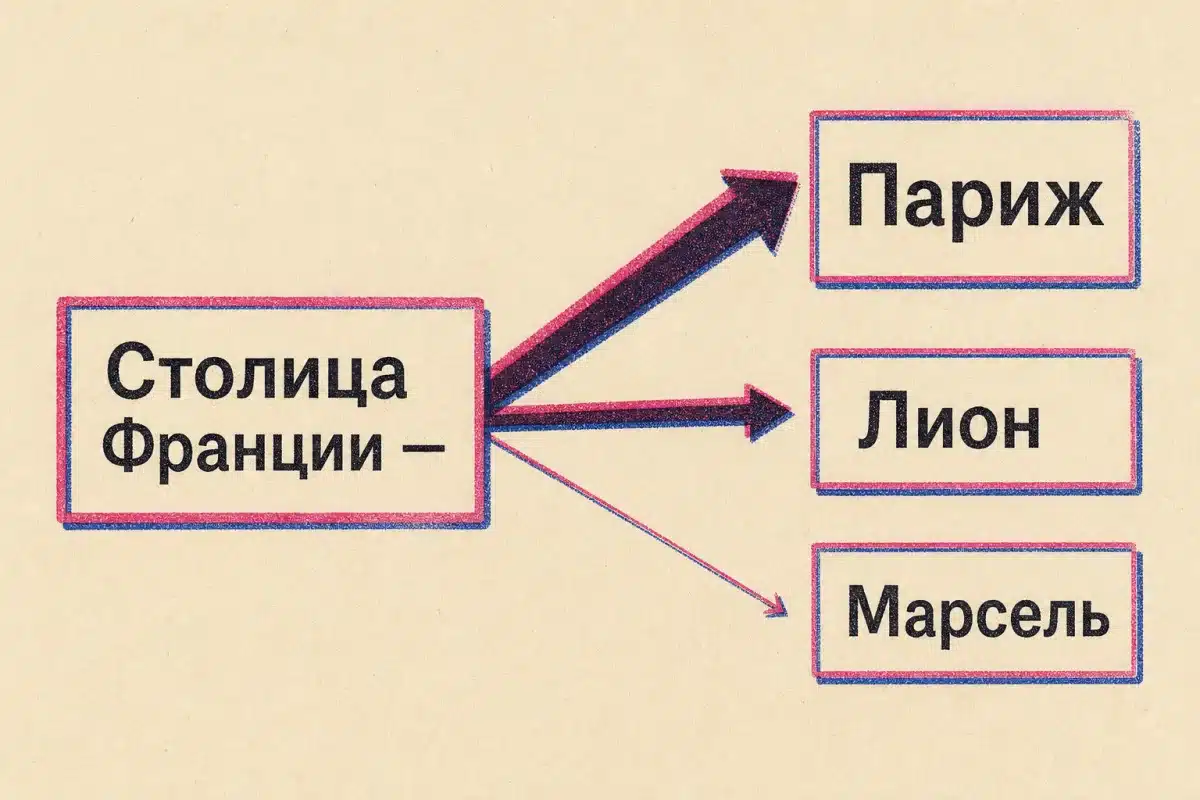
После «Столица Франции —» самое вероятное продолжение «Париж», и всё хорошо. Но тот же механизм работает, когда точного ответа у модели нет. Она не останавливается, а достраивает самое правдоподобное продолжение — и нейросеть выдумывает ровно там, где человек сказал бы «не помню».
Отсюда и качество подделок. Выдуманная ссылка выглядит как настоящая: фамилии авторов, название журнала, год, аккуратный адрес. Форму научной ссылки модель видела десятки тысяч раз, а конкретную статью — ни разу. Мой несуществующий хук из той же серии: правило именования усвоено, конкретное имя — нет.
Само по себе предсказание следующего элемента по предыдущим — идея старая, ей больше ста лет. Я разбирал её на цепях Маркова: там видно, что механизм не различает правду и правдоподобие в принципе.
Пять причин, по которым нейросеть выдумывает
1. В обучающих данных не было точного факта
Частые связи закрепляются хорошо: столицы, базовые термины, популярные библиотеки. Редкое — хуже. Название малоизвестного плагина, номер пункта регионального регламента, параметр функции из версии трёхлетней давности.
Но запрос всё равно требует ответа. Модель собирает его из похожих шаблонов: берёт форму, которую знает, и подставляет содержимое, которого не знает. Иногда угадывает. Иногда нейросеть выдумывает и подаёт это ровно так же уверенно.
Легче всего это ловится на версиях. Спросите про параметр функции, который появился в свежем релизе библиотеки, и получите ответ по мотивам старого: имя правильное, набор аргументов из прошлой мажорной версии, порядок перепутан. Ошибка не в логике, а в том, что модель усреднила пять лет документации в один ответ.
2. Вопрос допускает несколько прочтений
«Какой срок подачи заявления?» — какого заявления, в какой стране, по какому процессу, на какую дату? Человек переспросит. Модель чаще достраивает недостающие условия сама и молча.
Дальше она рассуждает логично, но от собственной догадки. Ответ выглядит связным и полностью мимо вашей задачи — а вы не видите, где именно разошлись, потому что предположение осталось у неё в голове.
3. В материалах есть противоречия
Вы загрузили две редакции договора, переписку и протокол встречи. В старой редакции срок десять дней, в новой пятнадцать, в письме обсуждали двадцать.
Для человека это сигнал: сначала определить действующую версию. Модель может незаметно склеить документы — взять срок из письма, формулировку из старой редакции и номер пункта из новой. Каждая деталь настоящая, ответ целиком неверный.
С кодом то же самое: два файла с похожими функциями, старый и новый. Модель может собрать ответ из обоих — взять сигнатуру из нового и тело из старого. Компилятор такое иногда пропускает, а поведение меняется молча.
4. Данные устарели
Цены, законы, версии программ, правила сервисов, названия методов в API — всё это меняется. Модель могла когда-то видеть правильный ответ, и сегодня он уже не правильный.
Формально это не выдумка. Практически — тот же результат: дату, цену или сигнатуру функции придётся сверить со свежим первоисточником.
5. Поиск или инструмент вернул не то
Доступ в интернет не делает модель безошибочной. Она может открыть нерелевантную страницу, принять короткий сниппет за содержание документа, неверно прочитать таблицу.
Инструмент даёт данные. Он не гарантирует, что модель правильно их поняла.
Почему модель не говорит «не знаю»
Молчаливая догадка выгоднее честного отказа. Многие процедуры обучения и оценки поощряют правильный ответ и никак не поощряют осторожность: угадал — плюс, признался в незнании — ноль. OpenAI разбирает эту механику в статье о природе галлюцинаций, и вывод там простой — модель обучена сдавать экзамен, а на экзамене пустой бланк хуже наугад поставленной галочки.
Вы и сами подталкиваете её к догадке. «Назови точную дату и дай ссылку» — формулировка, в которой уже заложено, что дата и ссылка существуют. «Не пиши, что не знаешь» закрывает единственный честный выход.
Фраза «если не уверен, так и скажи» помогает, но слабо: модель плохо оценивает собственную уверенность. Она может предупредить о сомнениях там, где права, и промолчать там, где ошиблась.
Поэтому не спрашивайте, уверена ли она. Просите показать точный фрагмент источника, номер пункта, результат теста или пересчёт калькулятором — то, что можно проверить самому.
И отдельно про тон. Ровная структура, точные числа, профессиональная лексика — это форма ответа, а не подтверждение его качества. Особенно подозрительна лишняя точность: если источника не было, а вам называют дату до дня, процент до сотых или дословную цитату, проверять надо в первую очередь именно это.
Чем длиннее контекст, тем чаще нейросеть выдумывает
Контекст — это всё, что доступно модели в текущем разговоре: инструкции, сообщения, файлы, ответы инструментов. Окна у современных моделей огромные, в них помещается книга или целый репозиторий. Вместимость и внимание — разные вещи.
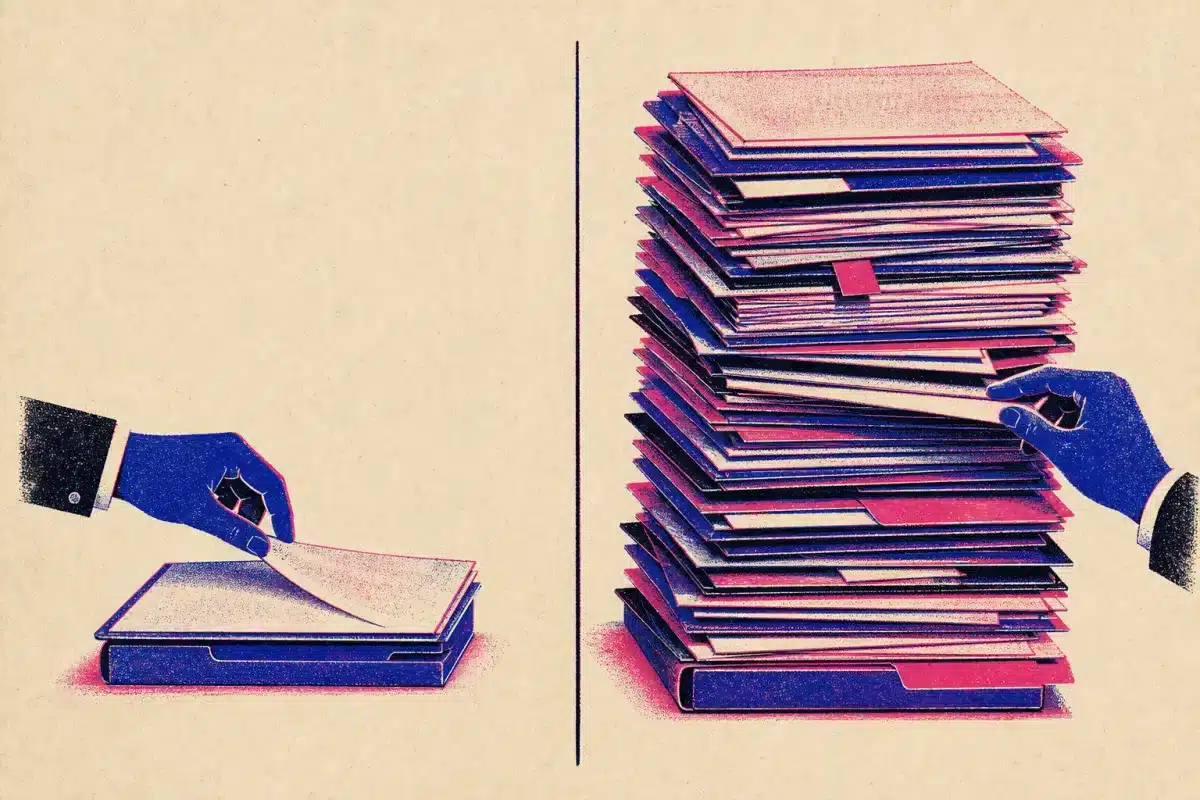
По мере роста контекста нужный факт конкурирует с сотнями похожих. Инструкция теряется между логами. Число из действующего договора смешивается с числом из черновика.
В 2025 году авторы теста NoLiMa проверили тринадцать моделей с заявленным окном от 128 тысяч токенов. Задачу составили так, чтобы вопрос и нужный фрагмент почти не совпадали по словам — искать пришлось по смыслу, а не по совпадению строк. На длине в 32 тысячи токенов почти все модели просели больше чем наполовину относительно своего результата на коротком тексте.
Ещё показательнее не сам провал, а его скорость: заметная просадка начиналась задолго до заявленного предела — уже на нескольких тысячах токенов, то есть на объёме обычной рабочей переписки с парой приложенных файлов.
NoLiMa мерил умение найти и связать сведения, а не частоту выдумок. Но практический вывод прямой: «окно на 128 тысяч» — это про то, сколько влезет, а не про то, с какой точностью оттуда достанут нужное.
Как не превращать контекст в склад
Начинайте новый чат, когда меняется задача. Обсуждение структуры сайта и разбор договора не должны жить в одной переписке только потому, что окно открыто.
При переходе перенесите короткий бриф:
- что делаем и какой результат считаем готовым;
- какие решения уже приняты и не пересматриваются;
- какие файлы и версии актуальны.
Грузите не всё, что нашлось, а то, что нужно для решения. Нужен один пункт договора — дайте этот пункт и соседние абзацы. Нужен весь документ — скажите, какой раздел смотреть первым.
Важные ограничения повторяйте прямо перед задачей. Не рассчитывайте, что модель безошибочно достанет правило из сообщения двадцатиминутной давности.
Если сервис позволяет удалить старое вложение — удалите. Если нет, попросите короткую сводку, проверьте её глазами и начните новый чат уже с ней.
У меня это выглядит так. Разобрались, как устроен нужный кусок кода, — записал итог в три строки и закрыл чат. Обсудили план правок — сохранил план, закрыл. Сделали первый кусок — закрыл. В следующую сессию заходят только эти три строки и два файла, а не сорок сообщений о том, какие варианты мы отвергли час назад.
Выглядит муторно, но именно это убирает основную долю выдумок в длинных задачах. Старые обсуждения перестают тянуть модель к решениям, от которых вы уже отказались.
Постоянные правила проекта держите не в переписке, а в файле рядом с кодом: в Codex это AGENTS.md, в Claude Code — CLAUDE.md. Что туда класть и чего не класть, я разобрал в отдельной статье. Главное правило то же: это не склад, а короткий свод того, что агент обязан помнить всегда.
Что не помогает
Три приёма, на которые надеются чаще всего, и почему они не закрывают вопрос.
Запрет в промпте. «Не выдумывай», «пиши только проверенное», «при сомнениях молчи» — модель не может выполнить эту инструкцию буквально, потому что не отличает изнутри знание от правдоподобной сборки. Запрет меняет тон ответа, а не механику его получения.
Включённый поиск. Он закрывает ровно одну причину из пяти — устаревшие данные. Всё остальное остаётся: страница может быть не та, сниппет прочитан не так, а вывод сделан шире, чем позволяет источник. Бывает и хуже — со ссылками ответ выглядит солиднее, и проверяют его реже.
Есть и четвёртый миф — что нейросеть выдумывает только на сложных вопросах. Наоборот: на сложных вы настороже и проверяете. Опаснее рутина, где ответ ожидаем и потому проходит без разбора.
Модель побольше. Сильная модель ошибается реже, но ошибается качественнее: её выдумка внутренне непротиворечива и оформлена так, что придраться не к чему. На редких фактах, свежих версиях и ваших внутренних документах преимущество почти пропадает — этих сведений не было в обучении ни у какой модели.
Отдельный случай — когда вы просите модель сыграть роль человека и ответить за него. Там выдумка гарантирована по построению, и почему именно так, я разбирал в статье про кастдев с нейросетью.
Какие ответы проверять всегда
Строгость должна быть разной. Варианты заголовка для черновика можно просмотреть по диагонали — цена ошибки нулевая. Но если ответ влияет на деньги, здоровье, права, безопасность или чужую репутацию, проверка обязательна.
Проверяю всегда:
- условия договоров, законы и судебную практику;
- медицинские рекомендации и дозировки;
- расчёты, налоги, цены и курсы;
- цитаты, даты, фамилии, должности и статистику;
- ссылки на исследования, книги и документы;
- команды, которые что-то удаляют или меняют на боевом сервере;
- имена функций, хуков и параметров из документации.
Проверка почти всегда дешевле последствий. Открыть страницу документации — полминуты. Найти цитату поиском по файлу — минута. Разобраться, почему заказы неделю не уезжали в CRM, и объясниться с заказчиком — совсем другой разговор.
Правило простое: чем точнее выглядит деталь и чем дороже ошибка, тем меньше причин верить ей без проверки.
Как поймать выдумку
Просите показать, откуда взялся вывод. Если ответ по документу — точную цитату и номер пункта. Потом найдите этот фрагмент сами, поиском по файлу.
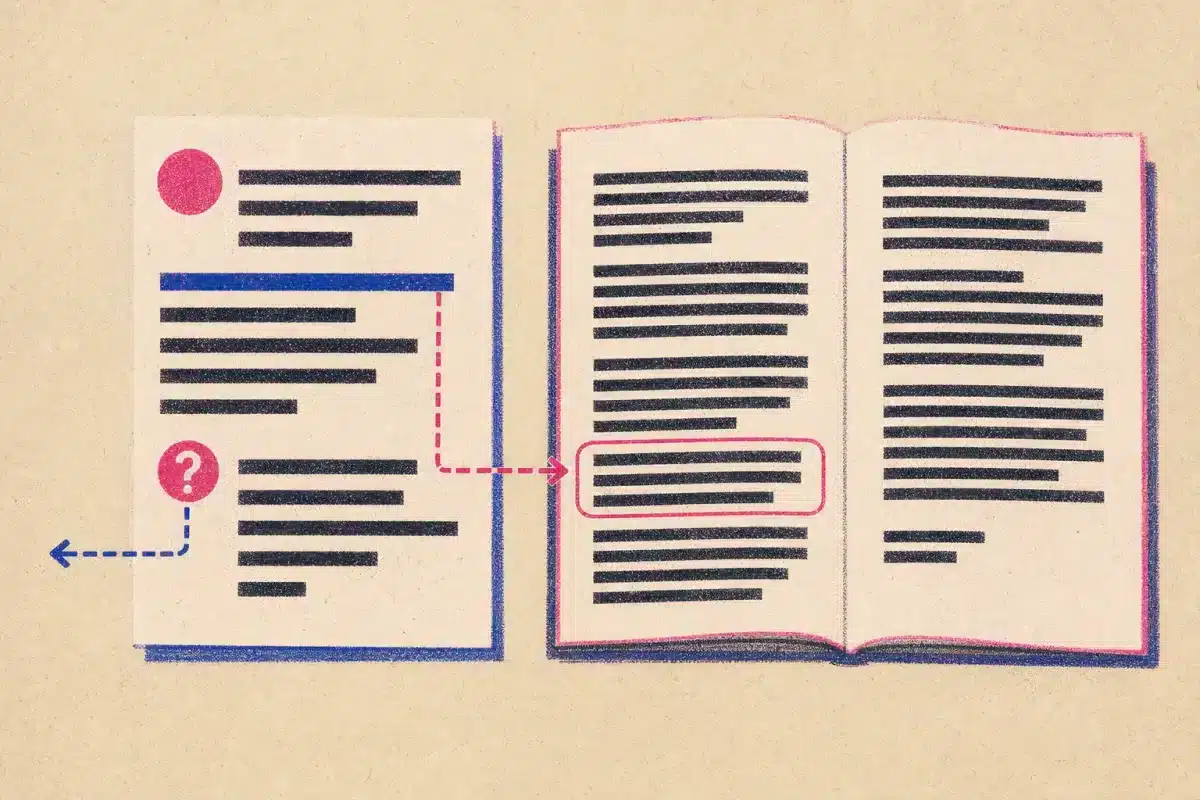
Если вместо цитаты приходит пересказ — это не подтверждение. Если ссылка ведёт на главную страницу организации, а не на конкретный документ — тоже.
Проверяйте, что источник подтверждает именно вывод. Ссылка бывает настоящей и при этом не о том: в статье метод тестировали на выборке из сорока человек, а в ответе он «доказал эффективность». Источник реальный, вывод выдуманный.
Это, пожалуй, самый частый вид ошибки: нейросеть выдумывает не источник, а связь между источником и выводом.
Смотрите не только на заголовок: дата, автор, область применения, ограничения и тот самый фрагмент, на который опирается ответ.
Разделяйте факты и выводы. Попросите оформить ответ в две части:
- что прямо сказано в источнике;
- какие выводы из этого сделаны.
Так сразу видно место, где заканчиваются данные и начинается догадка.
Считайте инструментом. Калькулятор, таблица, тесты и компилятор надёжнее уверенного тона. Если результат можно вычислить или запустить — не просите «подумать ещё раз», просите выполнить. Для кода это тесты, линтер и чтение реального diff. Для веб-страницы — открытая ссылка, а не пересказ сниппета.
Чтобы не держать это в голове, свёл признаки в таблицу.
| Что видите в ответе | Что сделать |
|---|---|
| Дата, процент или сумма с высокой точностью | Спросить источник числа и открыть его |
| Цитата в кавычках | Найти её поиском по исходному файлу |
| Ссылка на исследование или статью | Открыть и проверить, что там сказано именно это |
| Имя функции, хука или параметра | Сверить с документацией нужной версии |
| Формулировка «как правило», «обычно» | Уточнить, откуда правило и есть ли исключения |
| Расчёт в несколько шагов | Пересчитать инструментом, а не глазами |
И помните, что количество ссылок не равно качеству. Десять ссылок в конце ответа создают вид исследования, хотя ни одна может не подтверждать ключевой тезис. Две открытые и сверенные лучше двадцати декоративных.
Проверяет не тот, кто писал
Просьба «проверь себя» ненадёжна: модель видит уже написанный ответ и охотно соглашается сама с собой. Работает другое — отдельный запуск с чистого листа.
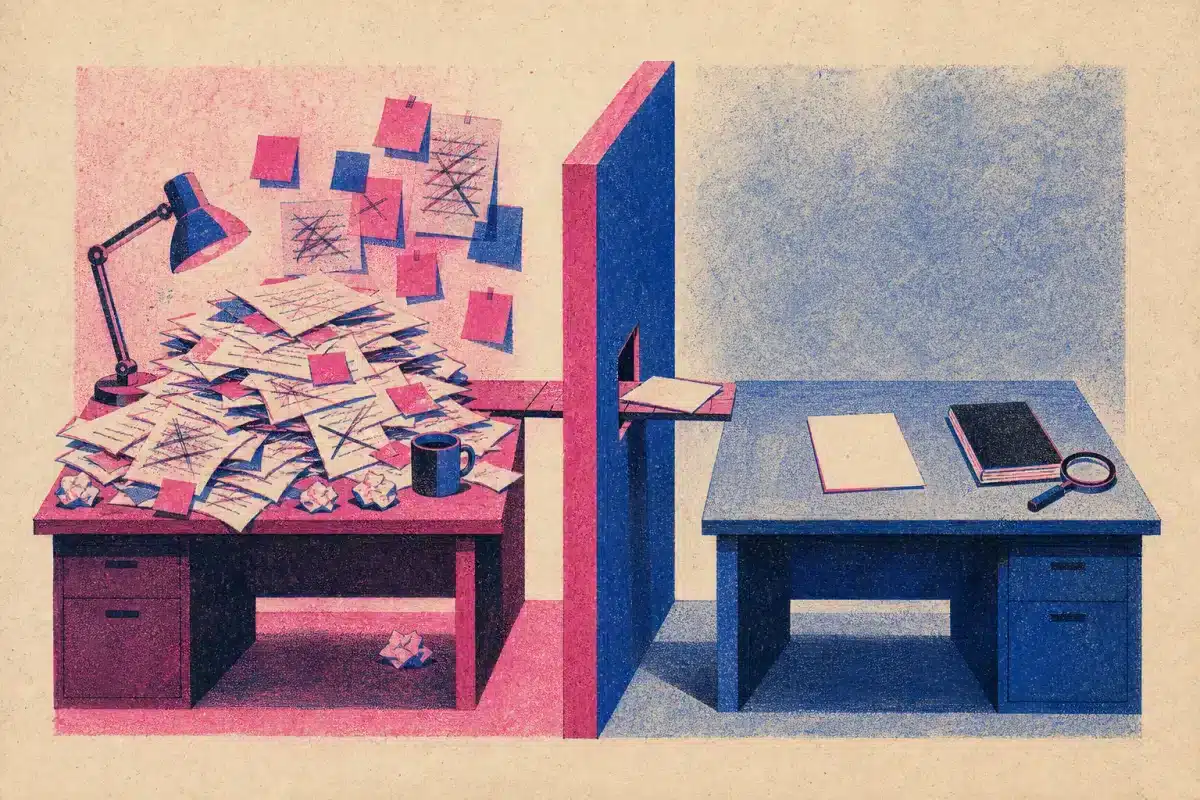
Дайте такому проверяющему исходную задачу, готовый результат, первоисточники и критерии — но не переписку, где первый агент десять раз объяснил, почему он прав. В Claude Code для этого есть субагенты с изолированным контекстом, в Codex — делегирование в отдельную ветку.
На AI Thumbnails Maker у меня так работают четыре проверяющих: совместимость с версиями WordPress, санитайзеры на входных данных, соответствие стандарту WPCS и целостность строк для перевода. Каждый в своей сессии, каждый не знает, что писал предыдущий.
Именно проверяющий по документации ловит истории вроде моего хука. Ему не рассказывают, что код уже написан и «работает» — ему дают список используемых функций и просят подтвердить каждую ссылкой на официальную страницу. Несуществующее имя отваливается на первом же пункте, потому что подтверждать нечем.
Отдельный проход не даёт гарантий сам по себе. Он становится сильным, когда проверяющий может открыть первоисточник, запустить тест или пересчитать число. Без внешней опоры второй агент повторит ту же ошибку — просто другими словами.
Как спрашивать, чтобы выдумок было меньше
Хороший запрос не запрещает выдумки волшебной фразой. Он сужает пространство для догадки.
Вместо «расскажи, что в договоре про штрафы»:
«Отвечай только по приложенной редакции договора. Найди условия о штрафах и неустойке. Для каждого вывода приведи точную цитату и номер пункта. Если условия нет, напиши: «в документе не найдено». Общие знания и типовые формулировки не используй».
Для актуальных сведений добавьте дату и источник: на какое число нужен ответ и с какого официального сайта его брать. Без даты модель принесёт правильное правило не того периода.
В большом файле сначала сузьте поиск: попросите перечислить разделы, где может быть ответ, прочитать только их, а в конце свести всё в таблицу «вывод — цитата — пункт — статус проверки».
Про температуру. Если интерфейс позволяет её менять, низкое значение делает выбор токенов менее случайным. Но факты этот параметр не проверяет: на нуле модель просто будет одинаково уверенно повторять одну и ту же ошибку.
Кстати, выдумка не всегда рождается на пустом месте — иногда её приносит сама формулировка запроса. Наглядный случай я разбирал в истории про гоблинов в ответах ChatGPT.
Коротко
- Модель предсказывает правдоподобное продолжение текста, а не сверяет каждую фразу с реестром истины.
- Нейросеть выдумывает чаще, когда факта не было в обучении, вопрос двусмыслен, данные устарели или в материалах противоречия.
- Длинный контекст вмещает много, но точность извлечения при этом падает — держите в окне только нужное.
- Уверенный тон и лишняя точность не доказательства, а поводы проверить.
- Проверять должен не автор ответа: отдельный запуск с чистым контекстом и доступом к первоисточнику.
- Чем уже границы запроса, тем меньше модели приходится додумывать за вас.
Полностью убрать выдумки пока нельзя. Надёжность даёт не удачная формулировка, а процесс, в котором выдумка находится до релиза, оплаты или отправки клиенту. Если агент ошибается у вас регулярно, посмотрите ещё разбор трёх причин — там про постановку задачи, а не про природу модели.


