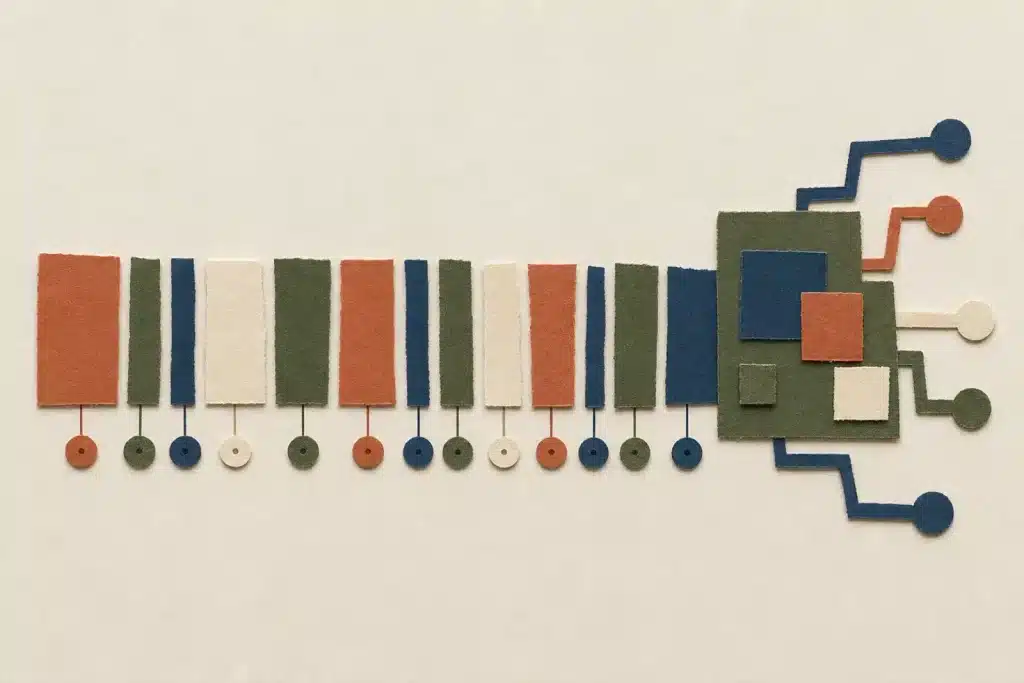
Токены — это кусочки текста, которыми нейросеть меряет всё, что вы ей пишете. Чаще всего это не целое слово, а его часть, знак или пробел. Когда сервис пишет «недостаточно токенов» или в чате кончается лимит, посчитаны именно они.
Перед отправкой в модель текст проходит через токенизатор: он режет слова и знаки на такие кусочки и заменяет их числами. Разберу, как это устроено, почему русский текст обходится дороже английского и на чём реально можно сэкономить.
Почему токен не равен слову
Возьмём фразу «Съешь ещё этих мягких французских булок, да выпей чаю». В ней 54 символа и 9 слов — а токенов получается 18. Английский перевод длиннее по символам, но укладывается в 13.
Внутри русской фразы «Съешь» разделилось на три части, а «мягких», «французских», «булок» и «чаю» заняли по две. При этом «и» и «этих» уместились в один токен каждое, вместе с пробелом впереди.
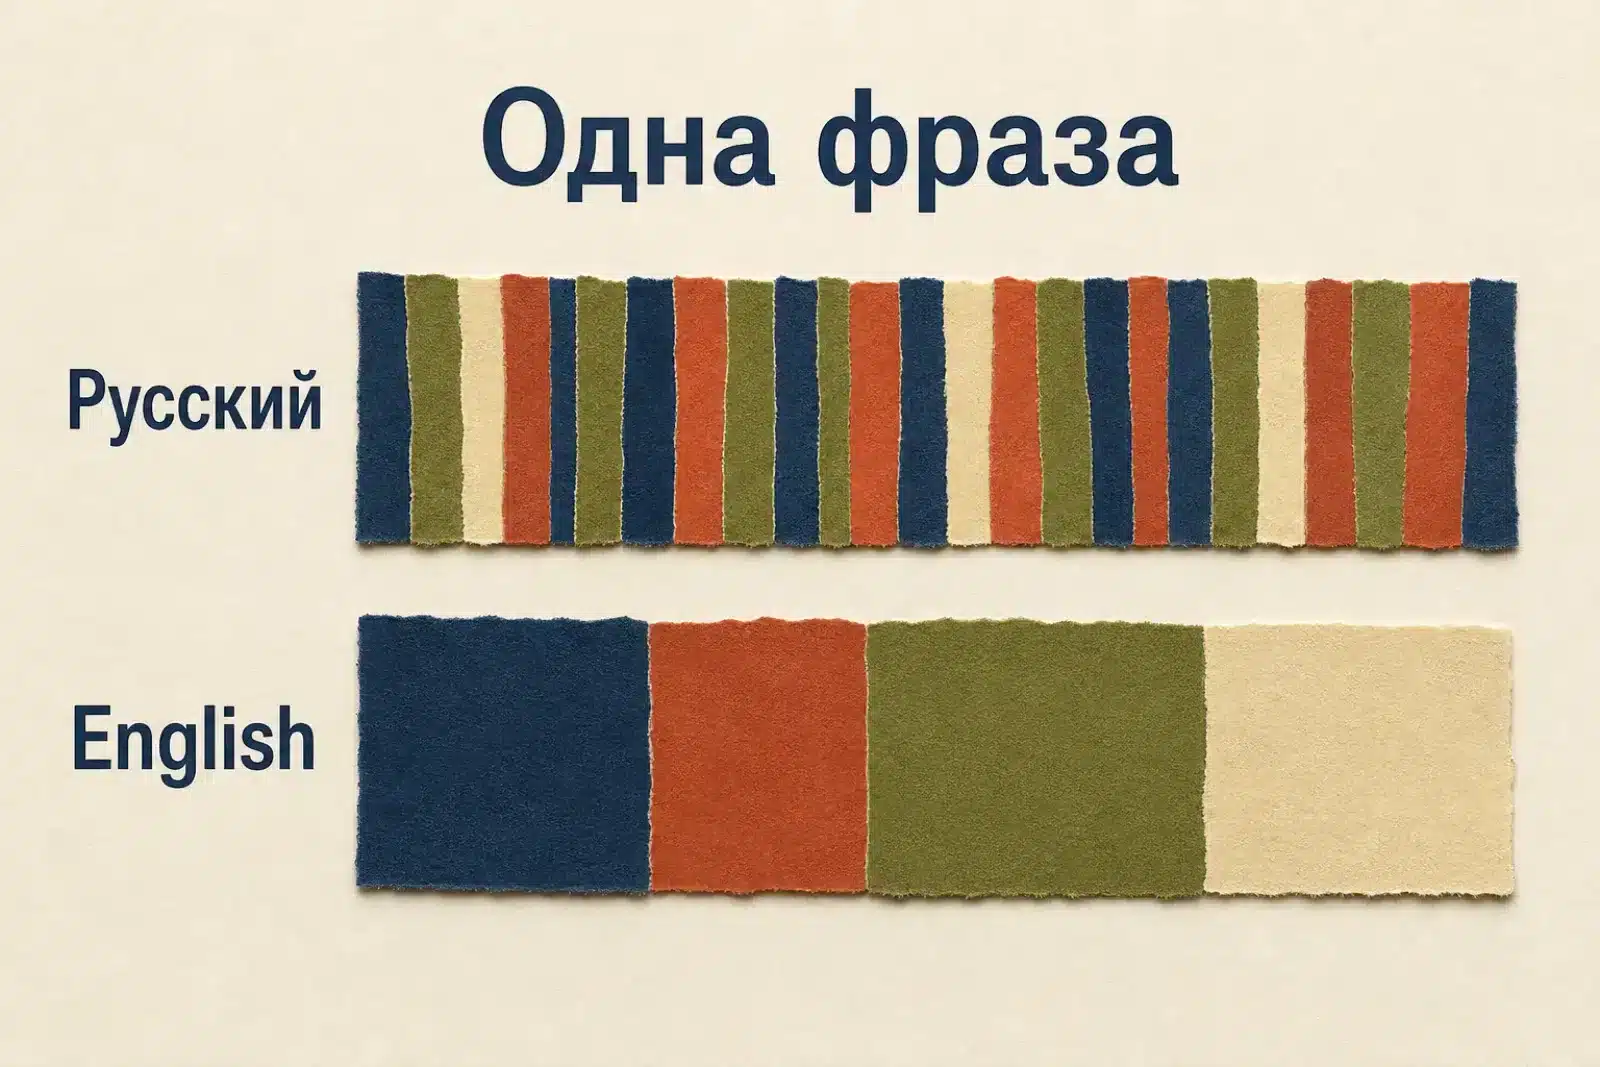
Токенизатор ничего не знает про корни и окончания. Он ищет в словаре куски написания, которые чаще всего встречались в обучающих текстах, поэтому граница проходит там, где вы бы её никогда не поставили.
Как устроен токенизатор
У него есть словарь, но внутри лежат не слова с определениями, а куски написания: «клиент», «кли», «ент», точка, запятая и десятки тысяч других последовательностей. У каждого куска свой номер.
Зачем куски, а не целые слова? Если кормить модель по одной букве, даже короткая фраза растянется в неподъёмную цепочку. Если хранить только целые слова, придётся отдельно записать «булка», «булки», «булок», «булками», каждую фамилию и каждую опечатку. Словарь из кусков решает обе задачи: частое хранится целиком, редкое собирается из частей.
Собирают такой словарь заранее и только один раз, на огромном массиве разнородных текстов. Самый ходовой алгоритм — BPE: он начинает с очень мелких частей, находит частые соседние пары и склеивает их. После множества проходов частые сочетания становятся отдельными токенами.
Дальше словарь идёт в комплекте с моделью и не меняется. Во время разговора токенизатор не придумывает новых токенов — он раскладывает ваш текст готовыми кусками. Незнакомое имя или опечатку он тоже соберёт, просто кусков понадобится больше.
Почему словарь у каждой модели свой
Словарь собирают вместе с моделью и под её задачи. У OpenAI, Anthropic и Google они разные по размеру и по составу, поэтому один и тот же абзац они разделят по-разному — расхождение в 10–15% на русском тексте обычное дело.
Размер словаря — это компромисс. Маленький словарь означает, что почти всё придётся собирать из мелких кусков: цепочки получаются длинными, окно забивается быстрее. Большой словарь укладывает частые слова в один токен, но сам занимает место в модели и хуже справляется с редкими словами, которых в нём нет.
Практическое следствие для тех, кто считает бюджет: цифру, полученную одним токенизатором, нельзя переносить на другую модель. Разница в 15% на объёме в миллионы токенов — это уже заметные деньги.
Отдельная история — языки с нелатинской письменностью. Русский, арабский, японский почти всегда дороже английского просто потому, что их было меньше в текстах, на которых собирали словарь. Это не про качество языка, а про статистику обучающего массива.
Что нейросеть делает с токенами
После разбиения фраза превращается в последовательность чисел. В номере не записано никакого определения: модель разворачивает его в вектор — набор чисел, кодирующий, с какими другими кусками этот токен обычно встречается. Про то, как из этого получается смысл, у меня есть отдельный разбор про эмбеддинги.
Порядок тоже учитывается. Во фразах «собака укусила человека» и «человек укусил собаку» одни и те же слова, но смысл противоположный.
Дальше модель повторяет одно действие: смотрит на всю цепочку и прикидывает следующий токен. Выбранный дописывается к тексту, и расчёт запускается заново. Ровно на этом принципе работает и простой генератор на цепях Маркова — разница в том, сколько предыдущего контекста учитывается.
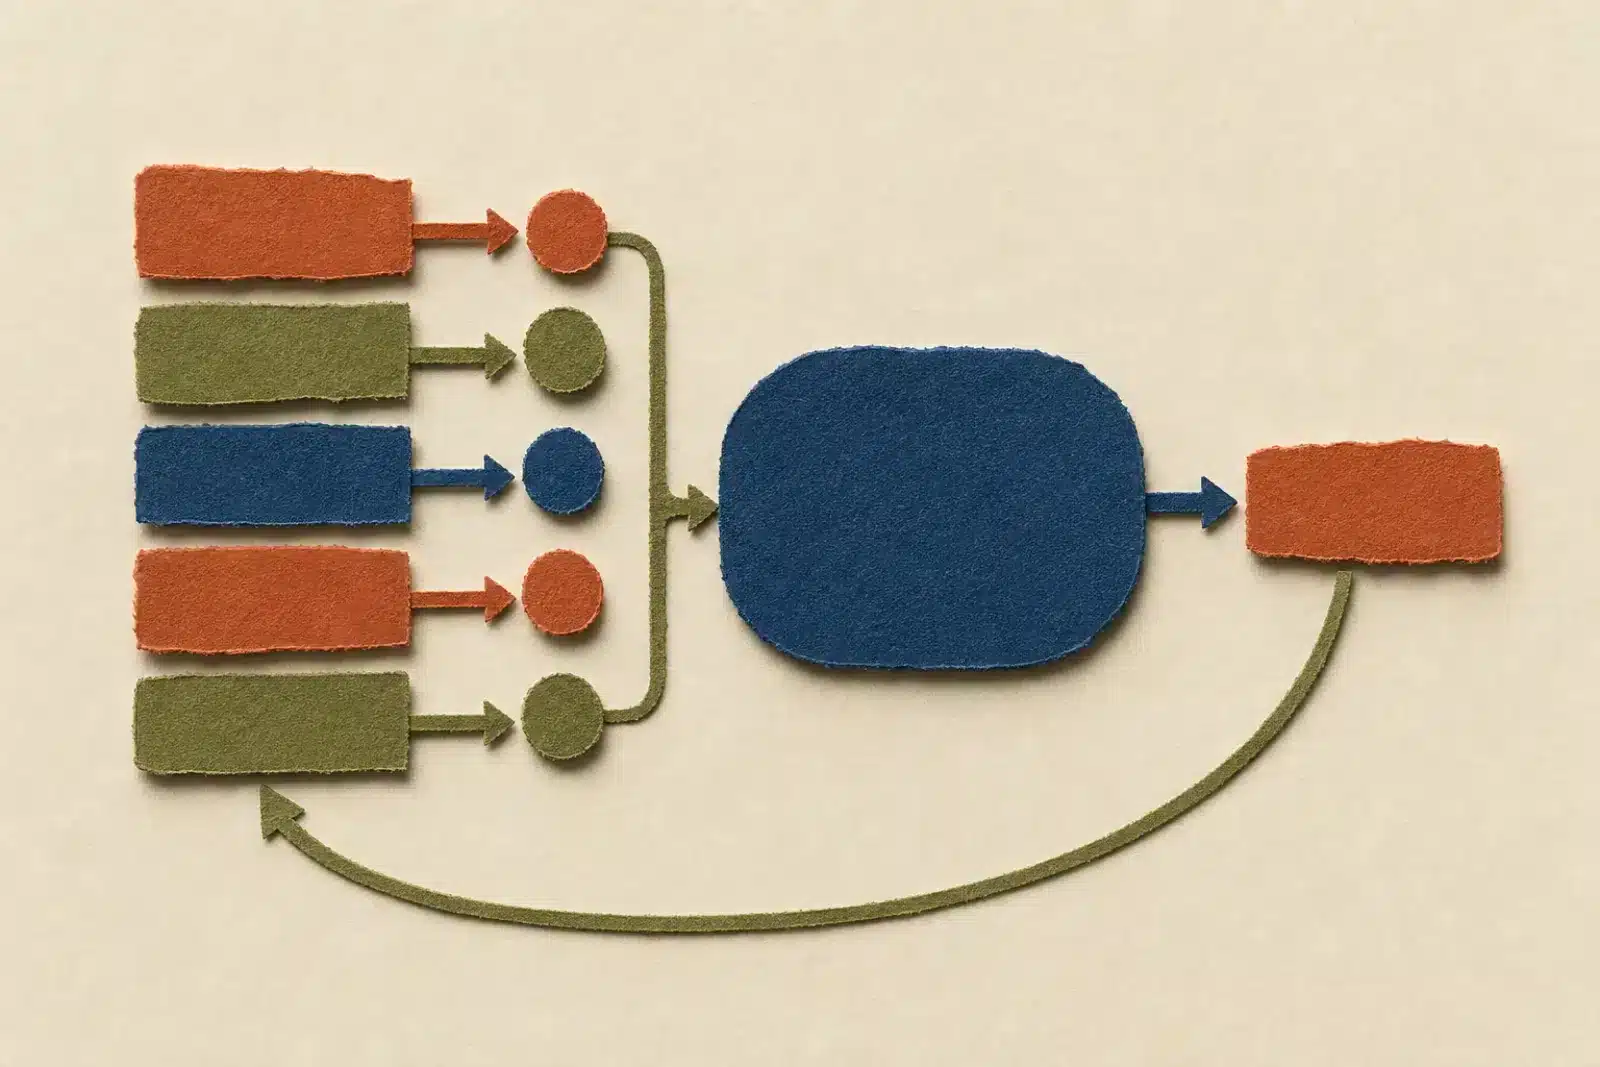
Токены нужны и на входе, и на выходе. Модель получает токены запроса и генерирует токены ответа, а приложение прогоняет их через токенизатор в обратную сторону и склеивает в привычный текст.
Обратное преобразование, кстати, не всегда идеально. Если генерация обрывается на середине токена, вы можете увидеть в конце ответа обрубок слова или странный символ — это не сбой модели, а незакрытый последний кусочек.
Отсюда же разница в скорости. Запрос модель обрабатывает целиком, а ответ пишет по одному токену — поэтому десять лишних абзацев в ответе заметнее по времени, чем десять лишних абзацев в инструкции.
Почему русский текст занимает больше токенов
В примере выше английские Eat, soft, French, rolls и tea поместились в отдельные токены. Русские «Съешь», «мягких», «французских», «булок» и «чаю» пришлось собирать из частей.
Причина в обучающих текстах: английского в них было в разы больше, поэтому алгоритм успел склеить частые английские сочетания в крупные токены. Русские формы такой частоты не набрали. Вдобавок у русского слова десяток форм, и каждая претендует на своё место в словаре — места на всех не хватает.
Но разница гуляет от фразы к фразе. Бывает почти паритет: «В четверг вечером мы долго гуляли по набережной и обсуждали новую книгу» — 18 токенов против 17 у английского варианта. А бывает и заметный перекос: «Маленький корабль медленно вышел из тумана и направился к далёкому берегу» — 24 токена против 15, на 60% больше.
Переходить из-за этого на английские промпты не стоит. В обычном чате экономия копеечная, а точность формулировки теряется. Смысл появляется только на больших объёмах через API — и то если ответ вам тоже нужен английский: русский ответ модель всё равно напишет русскими токенами, а он обычно длиннее запроса.
Где токены удивляют на практике
Пара наблюдений из работы, которые в справочниках обычно не пишут.
Код токенизируется хуже текста. Отступы, скобки, подчёркивания в именах переменных — всё это отдельные токены. Файл на 200 строк кода легко весит столько же, сколько три страницы прозы. Когда я отдаю агенту плагин на разбор, счёт идёт совсем не по числу строк.
Таблицы и JSON дороже, чем кажется. Каждая запятая, кавычка и фигурная скобка — токен. Один и тот же набор данных в виде простого списка обойдётся заметно дешевле, чем в виде красиво отформатированного JSON.
Повтор не бесплатен. Если вы в третий раз просите «сделай то же самое, но короче», модель заново получает и всю историю, и предыдущие варианты. Три уточнения подряд могут стоить дороже, чем один продуманный запрос.
Эмодзи и редкие символы дорогие. Один эмодзи — это часто два-три токена, а редкий символ вроде математического знака может занять и больше. На объёмах это заметно.
Контекстное окно: почему нейросеть забывает начало разговора
Контекстное окно — это сколько токенов модель держит перед глазами за одно обращение. Что не поместилось, для неё не существует.
В окно попадает не только последнее сообщение. Приложение отправляет системные правила, историю разговора, прикреплённый файл, результаты поиска, текущий вопрос — и оставляет место для ответа. Короткое «ок» в длинном чате уезжает к модели вместе с десятками предыдущих сообщений.
Размер окна у современных моделей — сотни тысяч токенов, у самых больших до миллиона. Звучит как бесконечность, но раздаётся быстро: договор на сто страниц — это уже порядка 50 000 токенов. Прикрепили его и задали десять вопросов — приложение может отправлять весь текст заново на каждом.
Полезно представлять окно не как память, а как стол ограниченного размера. Всё, что нужно модели для ответа, должно физически лежать на этом столе одновременно: правила работы, история, документы, ваш вопрос и место под черновик ответа. Ничего из этого не хранится «где-то ещё» — за пределами стола для модели пустота.
Когда место кончается, приложение выкручивается как умеет: удаляет начало разговора, сжимает старую историю или отказывается принимать запрос. Со стороны это выглядит как «нейросеть забыла, о чём мы договаривались». Лечится новым чатом, в первое сообщение которого вы кладёте нужные выводы.
Ответ тоже требует места, и у него обычно свой отдельный потолок, заметно меньше размера окна. Если ответ оборвался на полуслове — вы упёрлись именно в него. Помогает «продолжи ровно с места обрыва» или разбивка задачи на части. Та же переполненность окна, кстати, стоит за тем, что агент начинает ошибаться на длинных задачах.
Как токены превращаются в деньги
В чате вы платите за подписку и не видите цену каждого сообщения. Другое дело API — прямой доступ к модели из программы, мимо чата. Там провайдер считает каждый токен.
Входные токены — всё, что приложение отправило модели: инструкция, история, документ и сам вопрос. Выходные — видимый ответ и, у рассуждающих моделей, токены рассуждения: тот самый блок «думает», который модель пишет для себя. Он тоже оплачивается.
Формула простая: стоимость складывается из входных токенов, делённых на миллион и умноженных на ставку входа, плюс то же самое для выхода по своей ставке. Порядок величин такой: при ставке около $0,20 за миллион входных и $1,20 за миллион выходных один типовой запрос обойдётся примерно в половину десятитысячной доллара, а тысяча таких запросов — центов в сорок пять.
Важная деталь: выход почти всегда дороже входа в несколько раз. Триста токенов ответа могут стоить больше, чем пятьсот токенов запроса.
Из этого следует неочевидное правило: длинная подробная инструкция обычно выгоднее короткой. Она стоит копейки на входе, зато сокращает число переделок, каждая из которых оплачивается по дорогой выходной ставке. Экономия на инструкции — самая частая ошибка тех, кто впервые считает расход токенов.
И ещё одно. У рассуждающих моделей блок размышлений может оказаться в разы длиннее видимого ответа. Вы получаете три абзаца, а оплачиваете тридцать — просто остальные двадцать семь модель написала для себя. На задачах, где рассуждение не нужно, его стоит отключать явно.
Отдельная путаница — «токены» у сервисов-агрегаторов. Часто это внутренние баллы, которые списываются по курсу самого сервиса и с токенами модели не совпадают. Отличить просто: у токенов модели цена указана за миллион входных и выходных, у баллов — пакетами.
Пять способов расходовать токены экономнее
Сокращать промпт по слову бессмысленно: пять токенов из тысячи погоды не сделают, а телеграфный запрос без деталей обернётся переделками. Основной расход в другом:
- Старая история. Начинайте новый чат, когда меняется тема. Длинный чат дорожает сам по себе, даже если вы пишете короткие реплики.
- Документы целиком. Прикладывайте нужную главу вместо всего файла: вложение уходит модели заново с каждым вопросом. Десять вопросов по договору дешевле задать одним сообщением списком.
- Длина ответа. Просите формат и объём явно: «тезисно, до 10 пунктов». Выход дороже входа и дольше пишется.
- Кэширование для API. Повторяющееся начало запроса — например, длинную системную инструкцию — провайдер может считать по сниженной ставке, если оно совпадает от запроса к запросу.
- Лимит ответа для API. Ограничивайте максимальную длину генерации под задачу и сверяйте фактический расход по отчёту.
Что это значит при работе с агентами
В обычном чате про токены можно не думать. А вот когда вы запускаете агента, они становятся главной статьёй расхода — и главным ограничением качества.
Агент читает файлы, вызывает инструменты, получает результаты и снова думает. Каждый круг — это новая отправка всего накопленного контекста. Одна задача на полчаса легко съедает столько же токенов, сколько неделя переписки в чате.
Отсюда практика, к которой приходят все, кто с этим работает: резать задачу на этапы и сбрасывать контекст между ними. Это экономит не только деньги, но и качество — переполненное окно роняет точность быстрее, чем растёт счёт.
Второе место расхода — инструменты. Описание каждого доступного агенту инструмента уезжает в модель при каждом обращении. Подключили двадцать инструментов «на всякий случай» — и платите за их описания в каждом круге, даже если агент воспользовался одним.
Третье — файлы. Отдать агенту весь проект проще, чем разбираться, какие файлы нужны. Но за эту простоту вы платите дважды: деньгами за токены и качеством за раздутый контекст. Дешевле потратить минуту и указать конкретные файлы.
Как посчитать точное количество
Словари у моделей разные, и один и тот же абзац разные семейства разделят по-разному. Для расчёта бюджета берите инструмент той модели, которую собираетесь вызывать: у Google это документация по подсчёту токенов, у Anthropic — отдельный метод подсчёта.
Если вы вызываете модель через API, фактический расход возвращается вместе с ответом: отдельно входные, отдельно выходные и сумма. Цифра почти всегда выше, чем вы насчитали по видимому тексту, — приложение подмешивает системную инструкцию и описания инструментов.
Частые вопросы про токены
Что значит «недостаточно токенов»? Одно из трёх. Запрос не влез в контекстное окно — начните новый чат или приложите фрагмент вместо целого файла. Ответ упёрся в лимит генерации — попросите продолжить с места обрыва. Либо кончился баланс тарифа: подписка, API или внутренние баллы сервиса.
Можно ли пользоваться нейросетью без токенов? Нет. Токены — это способ, которым модель читает любой текст. В бесплатном чате они тоже тратятся, просто счёт оплачивает сервис.
Где взять бесплатные токены? В бесплатных лимитах самих сервисов: почти у всех есть уровень с ограничением по числу сообщений или объёму. «Бесплатные токены» сверх этого — обычно маркетинговое название внутренних баллов.
Чем подписка отличается от API? Подписка — фиксированная цена за месяц работы в чате, отдельно ничего покупать не нужно. API — оплата по факту за входные и выходные токены, включается в кабинете разработчика. У агрегаторов «токены» чаще всего означают внутренние баллы по их собственному курсу.
Почему счёт больше, чем я насчитал сам? К вашему тексту приложение добавляет системную инструкцию, описания доступных инструментов и историю. Видимая часть запроса — обычно меньшая его половина.
Влияет ли количество токенов на качество ответа? Косвенно, и сильнее, чем принято думать. Чем плотнее забито окно, тем хуже модель достаёт из него нужное. Поэтому короткий точный запрос часто даёт лучший результат, чем длинный с приложенными «на всякий случай» материалами.
Как токены связаны с качеством ответа
Есть распространённое заблуждение, что токены — вопрос исключительно денег. На самом деле они напрямую связаны с тем, насколько хорошо модель отвечает.
Модель не читает контекст как человек, последовательно и с одинаковым вниманием. Она распределяет внимание между всеми токенами сразу, и чем их больше, тем меньше внимания достаётся каждому. Нужный факт, лежащий в середине длинного документа, модель находит хуже, чем тот же факт в коротком запросе.
Токены здесь работают как единица не только счёта, но и внимания. Практический вывод получается обратным интуиции: докладывать в контекст «побольше материала для надёжности» — плохая стратегия. Каждый лишний блок токенов не только стоит денег, но и слегка размывает всё остальное.
Поэтому я отношусь к контексту как к ограниченному бюджету внимания, а не как к ёмкости для хранения. Вопрос не «влезет ли», а «нужно ли это модели прямо сейчас».
Проверить это легко на своей задаче. Задайте один и тот же вопрос дважды: сначала приложив документ целиком, потом — только нужный раздел. Токены во втором случае уйдут в разы меньше, а ответ чаще всего окажется точнее. Этот опыт убеждает лучше любых объяснений.
Коротко о токенах
Нейросеть читает текст не буквами и не словами, а токенами — кусками, на которые его режет токенизатор. Модель работает с номерами этих кусков и пишет ответ по одному токену за раз. Поэтому их количество не совпадает ни со словами, ни с символами, а русский текст обычно выходит дороже английского.
Все ограничения растут из одного правила: история чата, приложенные файлы, ваш вопрос и будущий ответ делят одно окно. Переполнилось — и модель «забывает» начало. А в API каждый токен превращается в деньги, причём выход обычно дороже входа.
Экономить поэтому стоит не на длине промпта, а на том, что уезжает к модели вместе с ним: на старой истории, лишних документах и слишком длинных ответах.