Эмбеддинги — это способ записать смысл числами так, чтобы близкие по значению вещи оказались рядом. Без них нейросеть не может сделать с текстом ровным счётом ничего: она не знает словарных определений и не оперирует словами напрямую.
Самый простой вариант перевода в числа — дать каждому слову произвольный код: «кот» пусть будет 17, «собака» — 93. Компьютер поймёт только то, что это два разных слова. По числам 17 и 93 не догадаться, что оба обозначают животных и что «котёнок» по смыслу ближе к «коту», чем к «экскаватору».
Значит, нужен другой способ — такой, который сохраняет связи.
Что такое эмбеддинги, если объяснять на карте
Представьте трёхмерную карту, на которой каждое слово получает свои координаты. «Кот» и «котёнок» оказываются совсем рядом. «Собака» немного дальше — другое животное, но всё же животное. А глаголы «летать» и «прыгать» лежат в совершенно другой области.
Список координат слова на такой карте и есть эмбеддинг. На практике измерений не три, а сотни или тысячи: человек такую карту целиком увидеть не может, зато компьютер прекрасно считает по ней расстояния.
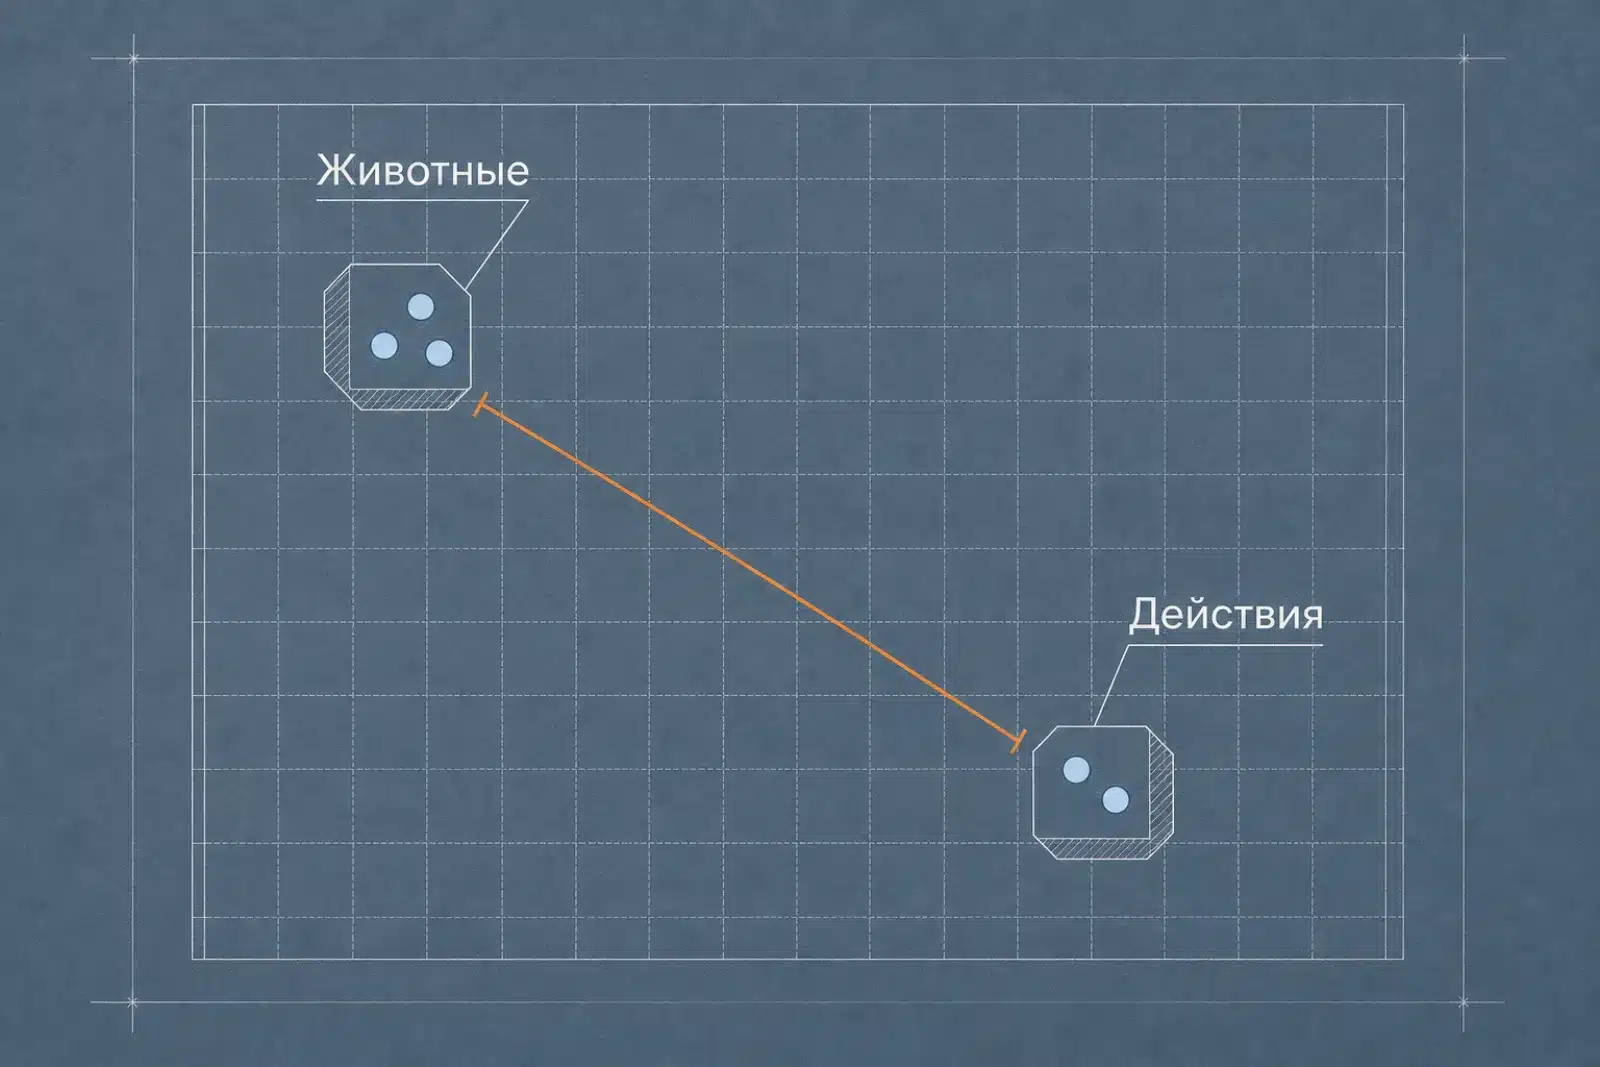
Благодаря этому интернет-магазин находит «компактную двухместную софу», когда человек ищет «небольшой диван для маленькой комнаты». Совпадающих слов почти нет, но смысл близкий — значит, и точки на карте окажутся рядом.
Точкой может стать не только слово. Эмбеддинги строят для целого текста, картинки, песни, товара или пользователя. Что именно означает близость, зависит от задачи: похожий смысл, схожий внешний вид, музыкальный вкус или поведение покупателей.
Почему нельзя просто пронумеровать слова
Стоит задержаться на этом, потому что здесь ломается интуиция. Казалось бы, какая разница, каким числом обозначить слово, — лишь бы они не путались.
Разница в том, что нейросеть умеет только считать. Она складывает, умножает и сравнивает числа, и никакой таблицы значений у неё под рукой нет. Если «кот» это 17, а «котёнок» 4302, то для сети это просто два далёких числа — ровно так же далёких, как 17 и 4302 в любом другом смысле.
При нумерации любые операции над числами дают бессмыслицу: среднее между «котом» и «собакой» окажется каким-нибудь «шкафом». А вот в пространстве эмбеддингов среднее между двумя близкими словами — это осмысленная точка где-то между ними.
Именно поэтому весь фокус в расположении, а не в самих числах. Эмбеддинги ценны не значениями координат, а тем, что расстояния между точками что-то означают.
Вектор и эмбеддинг: в чём разница
Вектор — это любой упорядоченный список чисел. Температуру воздуха за семь дней тоже можно записать вектором, и никакого смысла в нём не будет.
Эмбеддинг — это векторное представление объекта, построенное специально так, чтобы полезные для задачи связи отразились в геометрии пространства. Поэтому любой эмбеддинг является вектором, но не всякий вектор является эмбеддингом.
Количество чисел в векторе называют размерностью: вектор из 768 чисел имеет 768 измерений. Размерность задаёт сама модель, и больше — не значит лучше. Важнее, на каких данных и под какую задачу модель обучали.
Ещё одна важная оговорка: отдельную координату расшифровать нельзя. Не бывает так, что двадцатое число отвечает за «одушевлённость», а сотое за «размер». Смысл хранит весь вектор целиком, и работают только отношения между векторами внутри одной конкретной модели.
Как слово превращается в эмбеддинги
Возьмём фразу «Кот спит на диване». Сначала токенизатор режет её на кусочки — частое короткое слово может стать одним токеном, редкое распадётся на несколько. Про этот шаг у меня есть отдельный разбор про токены.
У каждого токена есть номер в словаре. Сам номер о смысле ничего не говорит — это просто адрес.
Внутри модели лежит матрица эмбеддингов, большая таблица чисел. Каждому номеру соответствует своя строка. Модель получает номер токена, открывает нужную строку и забирает оттуда начальный вектор.
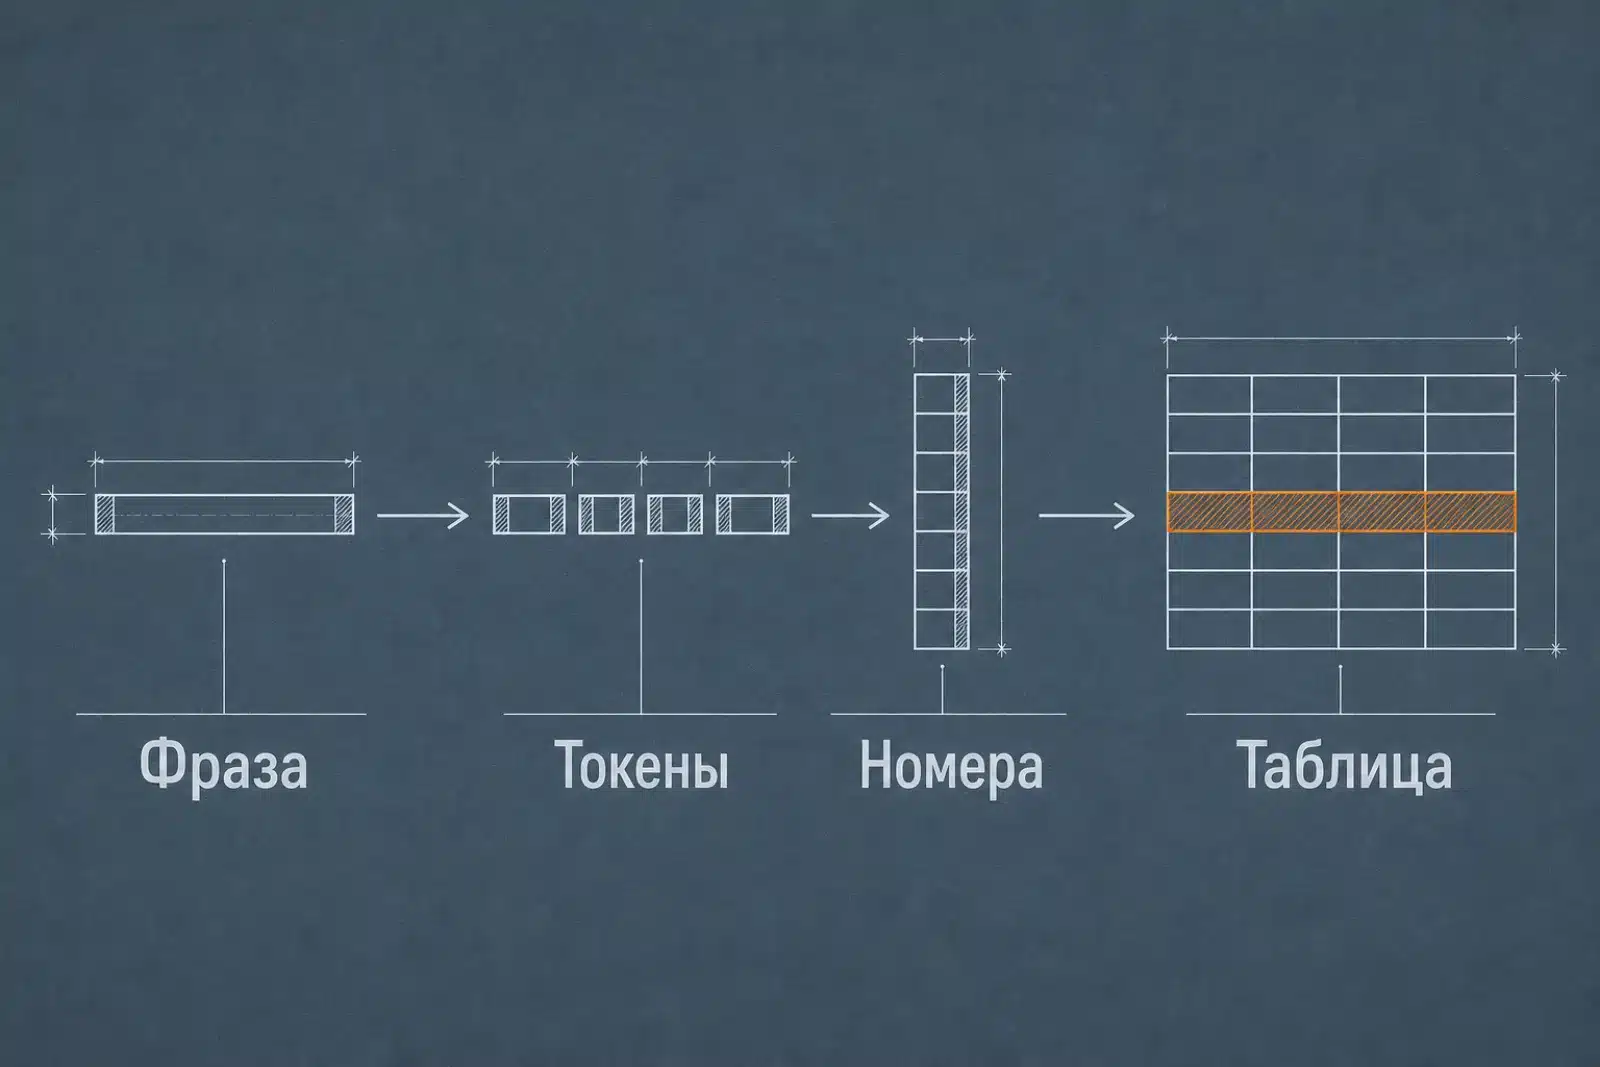
Когда модель только начинает обучаться, числа в таблице почти случайные: вектор «кота» ничем не лучше вектора «экскаватора». Полезное расположение появляется позже — модель много раз ошибается, правит свои параметры и постепенно двигает точки.
Откуда в эмбеддингах берётся смысл
Принцип тот же, каким пользуется человек с незнакомым словом. Если «бариста» раз за разом попадается рядом с кофе, чашкой, молоком и стойкой, довольно быстро становится ясно, о какой профессии речь. Определение при этом никто не давал.
Классический способ увидеть это — Word2Vec. Модель много раз угадывает соседние слова или пропущенное слово в середине фразы. Когда два слова помогают давать похожие ответы, их векторы постепенно сближаются. Работу опубликовала команда Томаша Миколова в 2013 году.
Современная языковая модель отдельный Word2Vec внутри не запускает: она обновляет таблицу начальных эмбеддингов вместе со всей сетью, пока учится предсказывать токены. Поисковые модели учатся иначе — сближают подходящие пары текстов и разводят неподходящие. Принцип общий: учебная задача определяет, что окажется рядом.
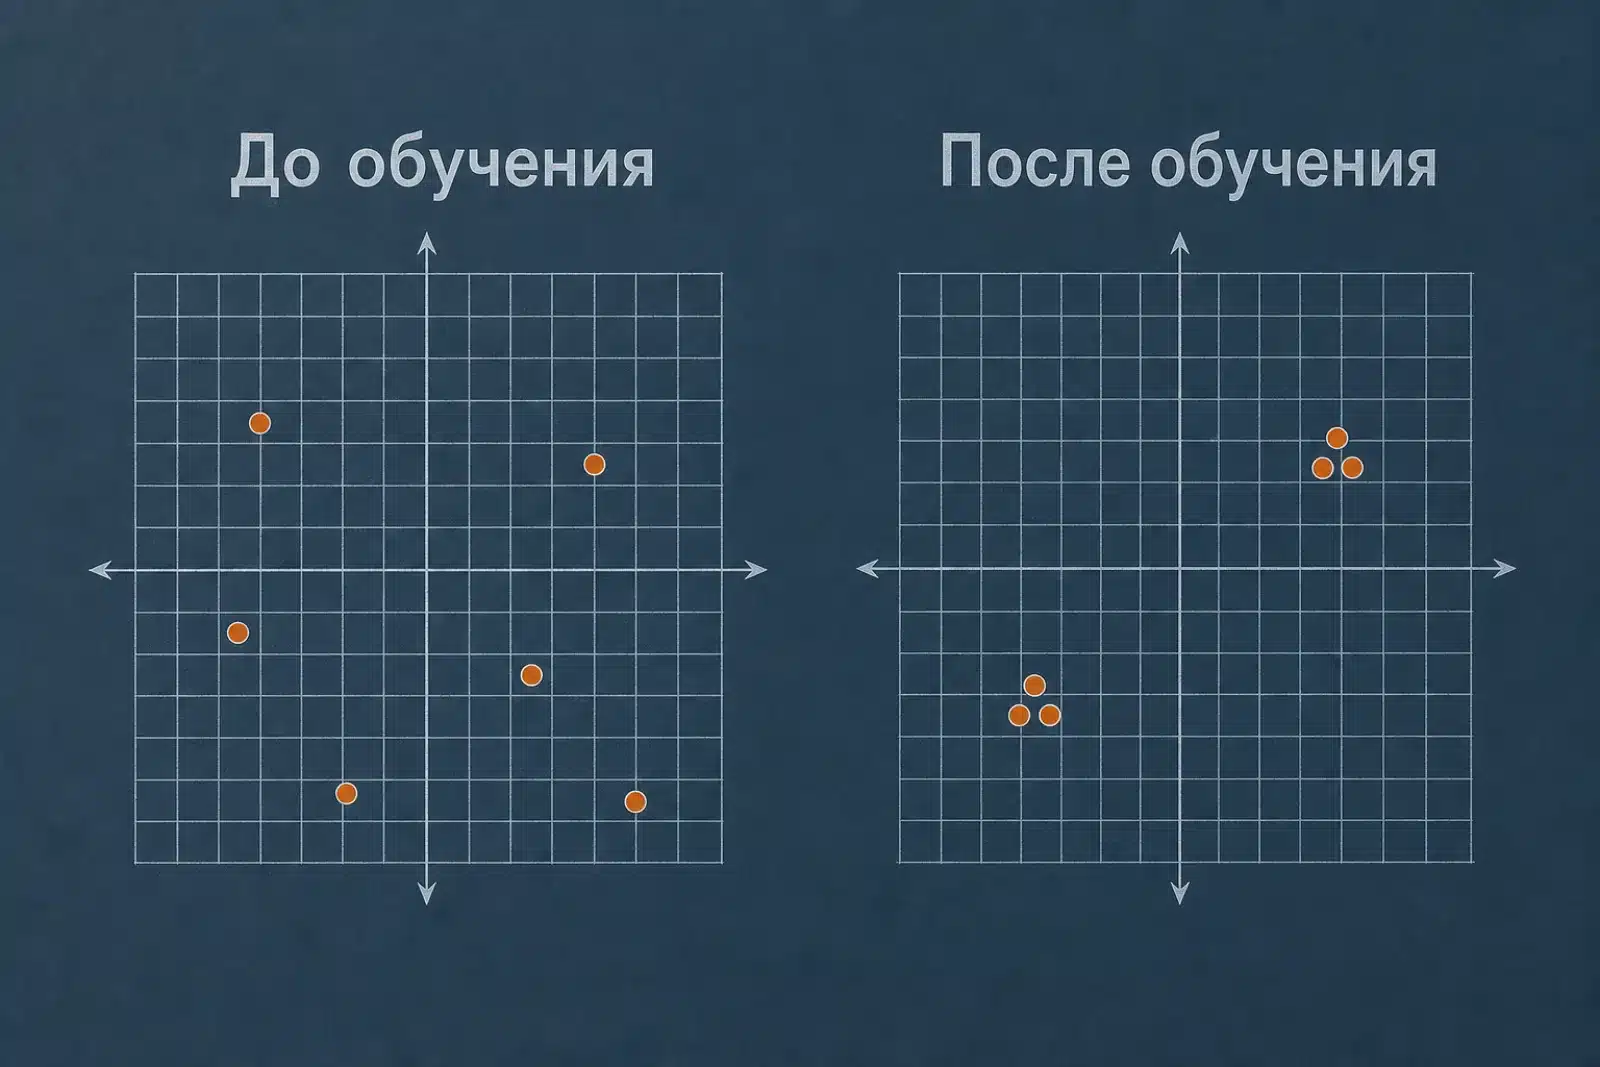
Здесь легко сделать лишний вывод: будто модель нашла единственно правильную карту языка. Такой карты не существует.
Пространство зависит от данных и задачи. Модель рекомендаций еды может поставить хлопья рядом с сосисками — и то и другое едят на завтрак. Модель для вегетарианского меню разнесёт их далеко. Обе карты правильные, просто для разных задач.
Почему у одного слова бывает несколько эмбеддингов
У Word2Vec есть неудобство: каждому слову достаётся один постоянный вектор. «Ключ» будет одной и той же точкой в предложении «ключ лежит у двери» и во фразе «нашли ключ к задаче». Модели приходится усреднять два разных значения в одно.
Современная модель пересчитывает представление каждого кусочка текста с учётом контекста и порядка слов. Поэтому один и тот же «ключ» получает разные векторы в разных фразах.
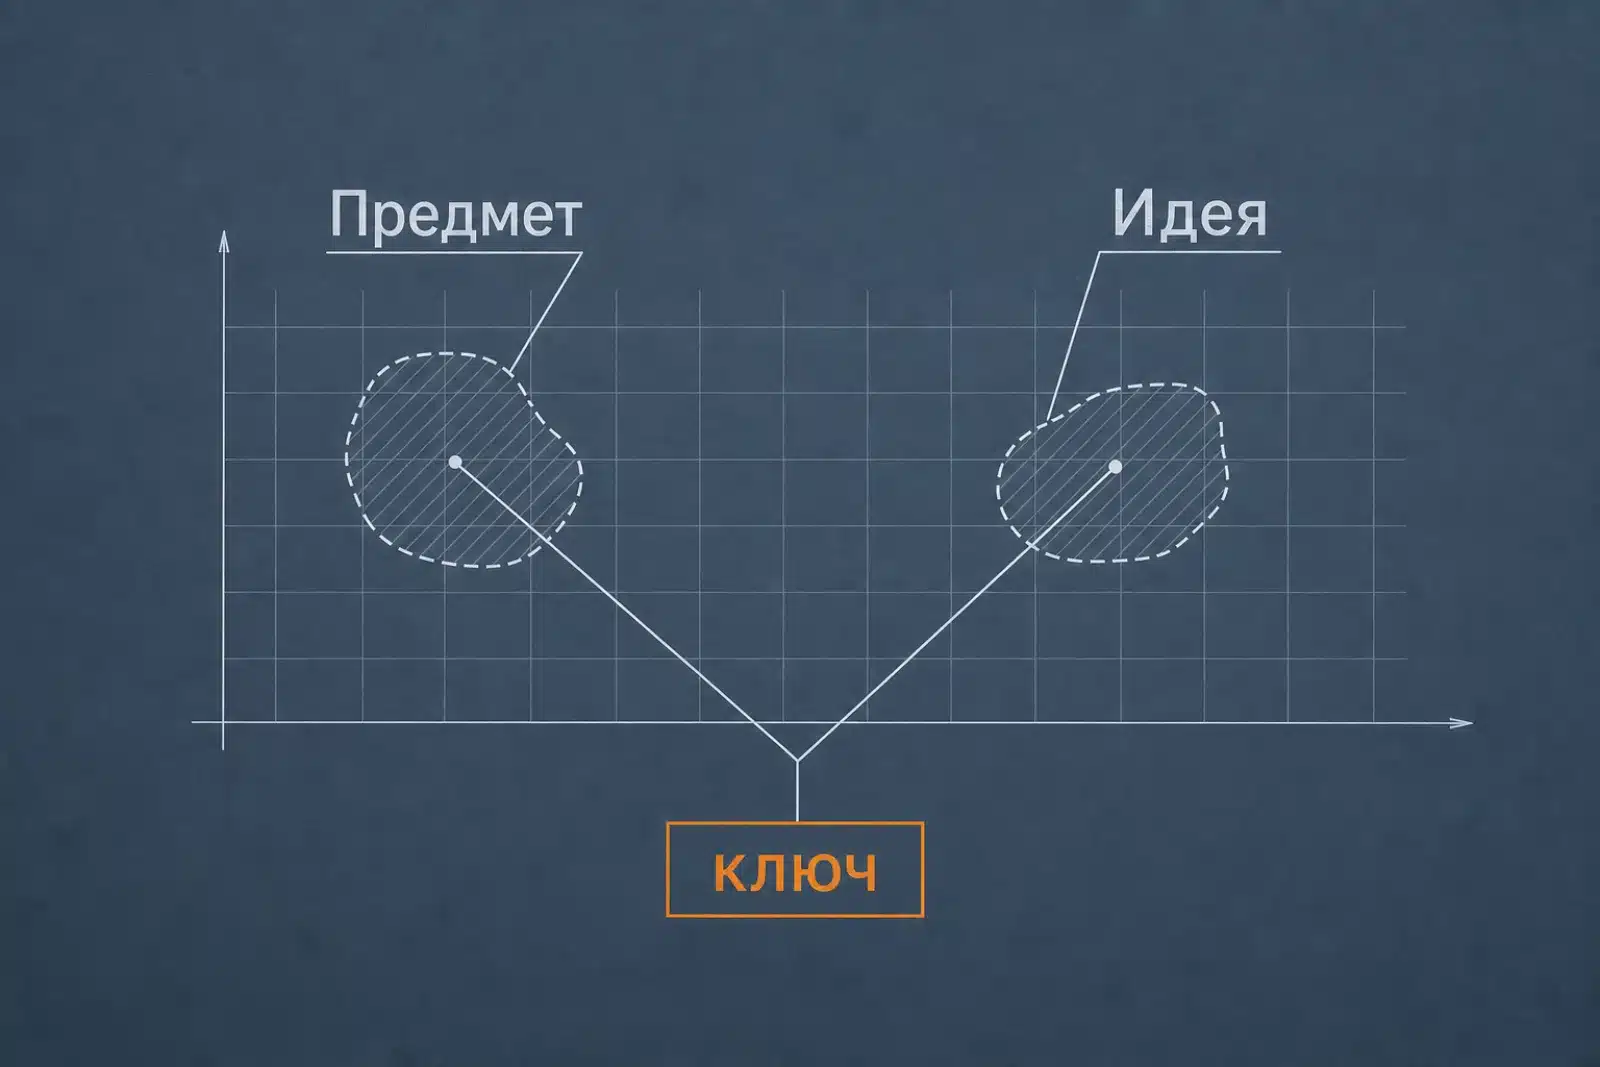
В архитектуре Transformer за это отвечает механизм внимания: модель оценивает, какие части фразы важны для каждого токена. Оригинальную схему авторы описали в работе Attention Is All You Need. Порядок слов тоже учитывается — иначе «собака укусила человека» и «человек укусил собаку» выглядели бы одинаково.
Тут легко спутать три разные вещи, и путают их постоянно:
- модель берёт начальный эмбеддинг из таблицы по номеру токена;
- слои сети заново считают контекстное представление для конкретной фразы;
- отдельная поисковая модель превращает целое предложение или документ в один вектор.
Во всех трёх случаях на выходе вектор. Но складывать их в одну коробку с надписью «нейросеть поняла смысл» не стоит — это разные механизмы с разными свойствами.
Почему карту нельзя нарисовать целиком
У современных текстовых моделей сотни или тысячи измерений. Нарисовать такое пространство невозможно — человек не представляет даже четырёхмерное.
Поэтому для наглядности карту сжимают до двух измерений специальными методами. На картинке становятся видны группы и соседи, и это полезно для проверки: если после сжатия ваши документы про доставку не собрались в кучку, что-то не так с моделью или данными.
Но при сжатии часть расстояний неизбежно искажается. Две точки, оказавшиеся рядом на плоской картинке, в исходном пространстве могут быть далеко. Плоская карта — иллюстрация, а не рабочий инструмент: все реальные расчёты идут по полным векторам.
Как компьютер сравнивает эмбеддинги
Когда два объекта стали векторами из одного пространства, близость можно измерить. Оговорка: сравнивать векторы только потому, что в них одинаковое количество чисел, нельзя — они должны быть из одной модели.
В текстовом поиске обычно берут косинусное сходство. Представьте два вектора как стрелки из одной точки: чем меньше угол между ними, тем выше сходство. Длина стрелок при этом отходит на второй план, важнее направление.
Формулу знать не обязательно. Для работы поиска достаточно цепочки:
- заранее посчитать эмбеддинги всех документов;
- превратить запрос пользователя в вектор той же самой моделью;
- быстро найти несколько ближайших документов;
- показать их в порядке близости.
Поэтому такой поиск называют семантическим: он ловит похожие формулировки без точного совпадения слов.
Гибридный поиск: почему одних эмбеддингов мало
На витрине интернет-магазина это видно лучше всего. Человек ищет «чехол на айфон 15 про макс» — здесь важна точность до модели, и эмбеддинги честно найдут ему чехлы на все айфоны подряд, потому что по смыслу они и правда близки.
А другой человек ищет «что-нибудь чтобы телефон не разбился» — и вот тут точный поиск не найдёт ничего, а эмбеддинги выдадут те самые чехлы.
Гибридный поиск запускает оба механизма и смешивает результаты: точные совпадения по артикулам и названиям идут выше, смысловые соседи дополняют выдачу. Настройка пропорции между ними — отдельная работа, но без неё каталог всегда будет промахиваться на одном из двух типов запросов.
Где эмбеддинги ошибаются
«Семантический» не означает «безошибочный». Если модель плохо знает предметную область или запрос двусмысленный, ближайшей окажется не та точка.
Близость к тому же не равна синонимии. «Врач» и «больница» часто лежат рядом, хотя это совершенно разные вещи. Та же история с антонимами: «горячий» и «холодный» встречаются в похожих фразах, поэтому и на карте оказываются недалеко друг от друга.
Геометрия хранит связи между словами, а не готовый словарь языка. Это стоит помнить всякий раз, когда семантический поиск выдаёт что-то на первый взгляд странное.
Как эмбеддинги ищут по смыслу: живой пример
Допустим, на сайте есть страница «Как вернуть деньги за отменённый рейс». Запрос «как вернуть деньги» целиком встречается в заголовке — обычный поиск по словам её найдёт.
Но человек может сформулировать ту же мысль иначе: «как получить компенсацию». Нужная страница на месте, а такой фразы нет ни в одном заголовке — и поиск по словам возвращает пустоту.
Векторный поиск сравнивает не слова. Пять страниц уже лежат на карте точками, запрос получает собственный эмбеддинг и становится шестой точкой. Ближайшей к нему оказывается как раз страница про возврат денег.
Обратите внимание, что никакого списка синонимов при этом никто не составлял. Связь между «вернуть деньги» и «получить компенсацию» возникла сама, из того, что в обучающих текстах эти обороты стояли в похожих местах. В этом главная экономия: эмбеддинги избавляют от ручного ведения словарей, которые в любом живом проекте всё равно устаревают быстрее, чем их пополняют.
В больших базах, где документов миллионы, перебирать все точки слишком долго, поэтому поиск ускоряют специальным индексом ближайших соседей — он находит почти ближайшие точки, но за доли секунды.
Как эмбеддинги используют на практике
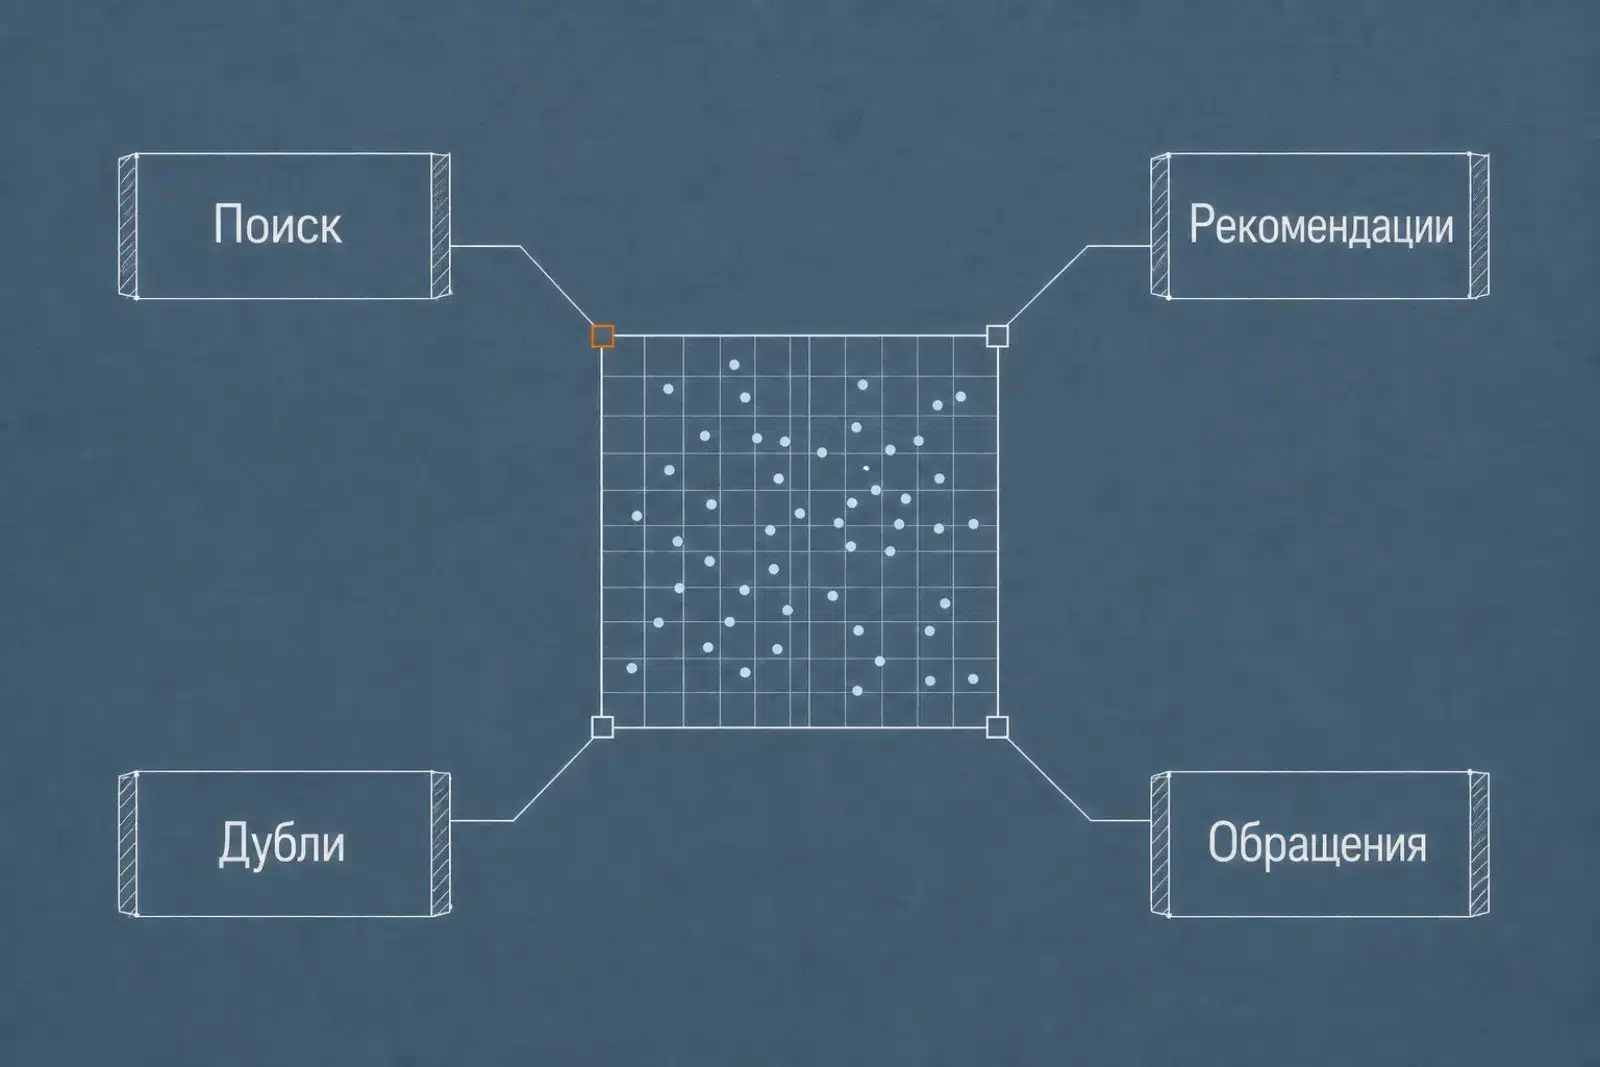
Список задач шире, чем кажется, и поиск — только первая из них.
Поиск по базе знаний. Самая частая. У компании накопились инструкции, регламенты и переписка, и сотрудник ищет ответ человеческими словами, а не терминами из документа.
Подсказки для модели. Прежде чем задать вопрос языковой модели, из базы достают несколько подходящих фрагментов и подкладывают их в запрос. Модель отвечает по ним, а не по памяти, и врёт заметно реже. Ищут эти фрагменты как раз по эмбеддингам.
Похожие товары и рекомендации. Карточка товара превращается в точку, соседние точки — это «с этим смотрят». Никаких правил вручную прописывать не нужно.
Разбор обращений. Тысяча писем в поддержку превращается в тысячу точек, и близкие точки собираются в группы. На выходе получается список повторяющихся проблем без ручного чтения.
Поиск дублей. Два текста про одно и то же, написанные разными словами, окажутся рядом. Для каталога с описаниями от разных поставщиков это экономит много времени.
Что обычно ломается
Эмбеддинги — технология с низким порогом входа и высоким порогом качества: работающий прототип собирается за вечер, а хорошая выдача требует возни. Вот на чём эта возня обычно застревает.
Несколько граблей, на которые наступают почти все, кто строит такой поиск впервые.
Разные модели для документов и запроса. Векторы обязаны быть из одного пространства. Посчитали базу одной моделью, а запрос другой — расстояния получатся случайными, и поиск будет выдавать чушь, не выдавая при этом никакой ошибки.
Слишком крупные куски. Если превращать в один вектор целую статью на десять страниц, её смысл усредняется до состояния «что-то про бизнес». Резать надо на осмысленные фрагменты — обычно абзац или раздел.
Слишком мелкие куски. Обратная крайность: нарезали по одному предложению, и каждый фрагмент потерял контекст. Ответ находится, но без окружения он непонятен.
Забыли пересчитать. Документ поменяли, а эмбеддинг остался старым. Поиск продолжает находить по устаревшему смыслу. Пересчёт при изменении надо закладывать сразу, потом это дорого чинить.
Когда что использовать
Правило выбора простое, и держать его в голове полезно ещё до того, как вы напишете первую строчку кода. Промах на этом шаге стоит дороже всего остального: переписать нарезку или сменить модель можно за вечер, а перестроить продукт вокруг неподходящего типа поиска — уже нет.
Ориентируйтесь так:
- Точный поиск — для артикула, номера договора, фамилии или цитаты. Тут важно посимвольное совпадение, и эмбеддинги только помешают.
- Поиск по эмбеддингам — когда одну мысль формулируют разными словами: база знаний, поддержка, каталог товаров с человеческими описаниями.
- Гибридный поиск — когда важны и смысл, и точные названия или числа. На практике в интернет-магазинах нужен чаще всего именно он.
Из практики добавлю наблюдение про то, где эмбеддинги подводят. Соблазн заменить обычный поиск векторным целиком возникает почти всегда, и почти всегда это ошибка. Клиент, который ищет «артикул 4711-02», хочет ровно этот товар, а не пять похожих по смыслу. Гибрид скучнее в описании, но работает предсказуемее.
И второе: качество поиска по эмбеддингам упирается не в код, а в выбор модели. Модель, обученная на английских текстах, на русском каталоге даст заметно худшие соседей — проверять это надо на своих данных до того, как всё построено.
Чем эмбеддинги отличаются от того, что делает языковая модель
Путаница между этими двумя вещами встречается постоянно, поэтому разведу их явно.
Модель, которая считает эмбеддинги, на выходе даёт один вектор — набор чисел. Она ничего не пишет и не отвечает, её работа заканчивается на числах. Такие модели специально обучены так, чтобы близкие по смыслу тексты давали близкие векторы.
Языковая модель на выходе даёт текст. Внутри она тоже работает с векторами, но её задача другая — предсказать следующий токен. Эмбеддинги внутри неё — промежуточное состояние, а не результат.
Отсюда практический вывод: брать языковую модель для поиска по смыслу неправильно, даже если технически можно вытащить из неё внутренние векторы. Она обучалась не на ту задачу, и соседи получатся хуже, чем у специальной модели вдесятеро меньшего размера.
Обратное тоже верно: модель для эмбеддингов не сможет ответить на вопрос. Она найдёт подходящий документ, а сформулировать ответ по нему — работа языковой модели. В связке они и используются.
Как выбрать модель под свою задачу
Готовых моделей, которые считают эмбеддинги, десятки, и выбор между ними важнее, чем кажется. Пара ориентиров из практики.
Язык. Модель, обученная преимущественно на английском, на русском тексте будет заметно слабее: соседи получатся правдоподобными, но неточными. Смотрите, заявлена ли поддержка русского явно, а не «мультиязычность» вообще.
Длина входа. У каждой модели есть предел, сколько текста она принимает за раз. Если ваши фрагменты длиннее, лишнее просто отрежется — молча, без предупреждения, и вы получите эмбеддинги от половины документа.
Размерность. Векторы на 1536 чисел точнее, чем на 384, но занимают вчетверо больше места и дольше сравниваются. На базе в тысячу документов разницы не заметите, на миллионе — почувствуете и в деньгах, и в скорости.
Где считается. Часть моделей работает только через API, часть можно поставить у себя. Если документы чувствительные, второй вариант единственный: иначе вы отправляете весь свой архив наружу.
Проверять всё это надо на своих данных. Возьмите два десятка реальных запросов, посмотрите, что модель выдаёт в ближайших соседях, и сравните два-три варианта между собой. Час такой проверки экономит недели переделок.
Сколько стоят эмбеддинги
Вопрос возникает у всех, кто прикидывает такой поиск для своего проекта, и ответ обнадёживающий.
Считать эмбеддинги дёшево — заметно дешевле, чем спрашивать языковую модель. Расход считается по тем же токенам, но ставки на порядок ниже, и ответ генерировать не нужно.
Основная статья расходов не в подсчёте, а в хранении и поиске. Миллион документов по 1536 чисел — это уже несколько гигабайт, которые надо где-то держать и по которым надо быстро искать. Отсюда и берутся специализированные хранилища векторов.
Практическое следствие: пересчитывать эмбеддинги всей базы не страшно и не разорительно. Если вы решили сменить модель на более подходящую, это вопрос нескольких часов работы, а не бюджета проекта.
С чего начать, если хочется попробовать
Порядок такой, и он занимает вечер.
Соберите пару сотен своих документов — статьи, инструкции, описания товаров, что угодно. Порежьте их на осмысленные куски: раздел или абзац, не больше страницы. Посчитайте эмбеддинги для каждого куска выбранной моделью и сложите рядом с текстами.
Дальше возьмите двадцать реальных запросов — таких, какие правда задают люди, а не такие, какие удобно проверять. Посчитайте эмбеддинги запросов той же моделью и для каждого найдите пять ближайших кусков.
И прочитайте, что нашлось. Это и есть проверка: если в первой пятёрке лежит нужное — работает. Если нет — меняйте либо нарезку, либо модель, в таком порядке. Как показывает практика, в девяти случаях из десяти дело в нарезке.
Один совет напоследок. Не начинайте с векторной базы данных. Для двухсот документов достаточно посчитать всё один раз и держать в обычном файле, а сравнивать перебором — на таком объёме это доли секунды. Специализированное хранилище понадобится, когда документов станут десятки тысяч, и к тому моменту вы уже будете понимать, чего именно от него хотите. Обратный порядок — сначала поднять хранилище, потом разбираться с нарезкой — стоит дороже и учит меньшему.
Коротко
Эмбеддинги — это координаты объекта в пространстве, устроенном так, что близкие по смыслу вещи лежат рядом. Числа берутся не из словаря, а из обучения: модель двигает точки, пока не научится решать свою задачу.
Отдельное число в эмбеддинге ничего не значит, единственно верной карты не существует, а близость на ней — это не синонимия, а совместная встречаемость. Понимания смысла в человеческом виде здесь нет, и именно отсюда растут многие ошибки моделей.