ИИ-агент ошибается почти всегда по одной из трёх причин, и все три лечатся. Мне регулярно пишут одно и то же: попробовал агента, он теряет инструкции и выдаёт ерунду, ничего серьёзного доверить нельзя. Дальше следует вывод, что технология сырая.
Технология не сырая. У неё есть условия, без которых она правда не работает. Я на них наступил сам, когда впервые отдал агенту рефакторинг Unnotifier и получил кашу из наполовину переписанных файлов.
Разберу три причины, по которым ИИ-агент ошибается чаще всего, и что делать с каждой.
Причина 1. ИИ-агент ошибается тем чаще, чем длиннее контекст
Это работает наоборот к интуиции. Кажется, что чем больше материала дашь модели, тем лучше она поймёт задачу. На практике наоборот: чем больше в окне лишнего, тем выше шанс, что агент зацепится не за то.
Anthropic описывает это как «context rot» — с ростом числа токенов падает точность, с которой модель достаёт из контекста нужное. Внимание у неё устроено как бюджет: он тратится на каждый токен, который вы положили в окно, полезный или нет.
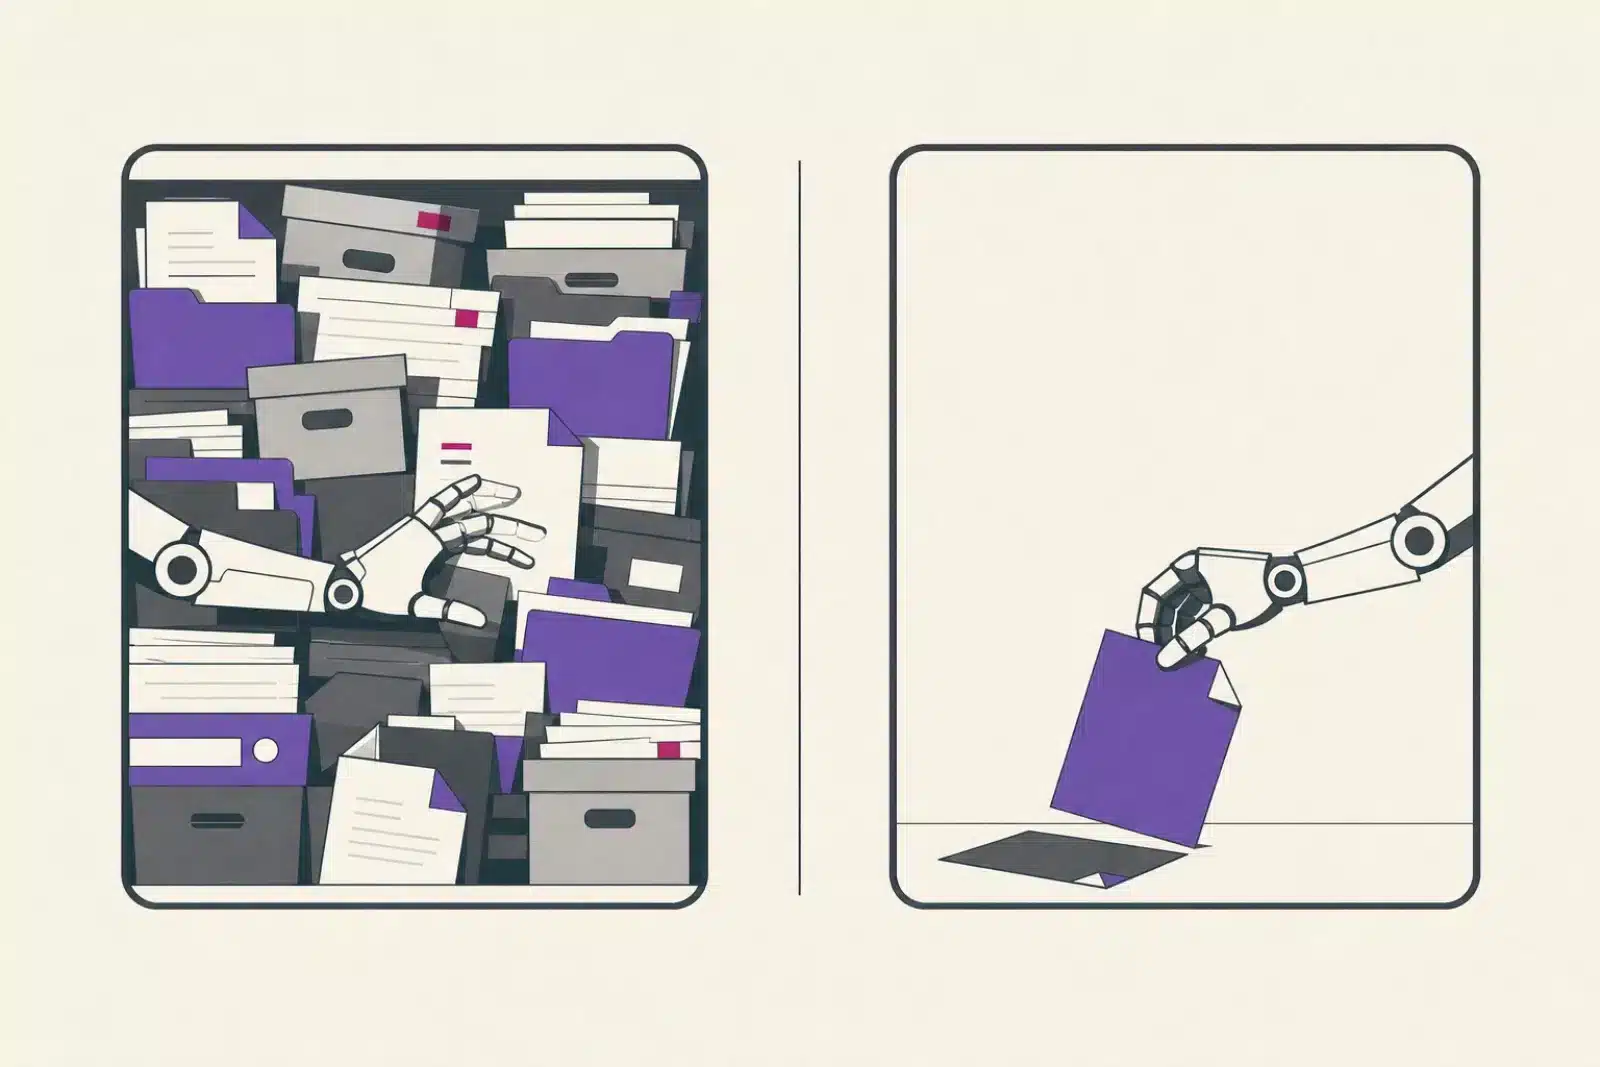
Поэтому в агента идёт минимум. Не весь плагин, а два файла с нужной логикой. Не вся документация WooCommerce, а конкретный раздел про хуки оформления заказа. Не вся переписка с заказчиком, а три строчки требований.
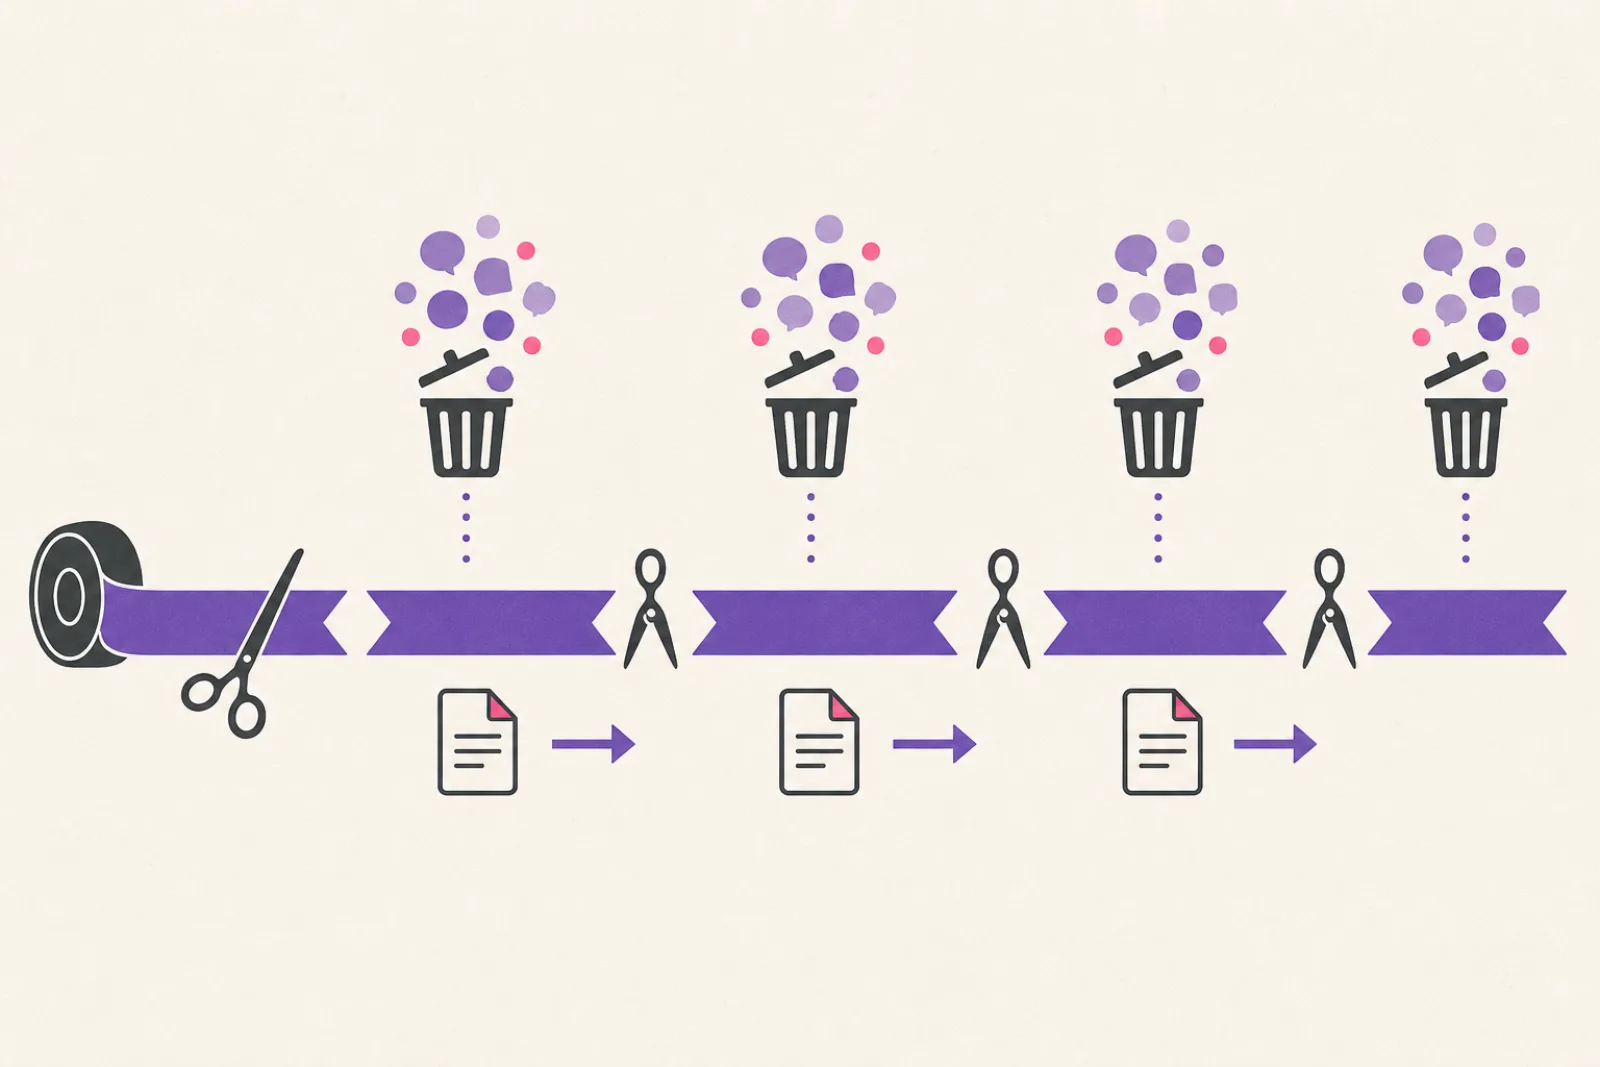
Отсюда второе: задачу надо резать на этапы и сбрасывать контекст после каждого. Разобрались в коде — записали саммари и сбросили. Обсудили план — сбросили. Сделали кусок — сбросили. Муторно, но именно это убирает большую часть выдумок: старые обсуждения перестают тянуть агента к вариантам, от которых вы отказались двадцать сообщений назад.
Чтобы не пересказывать устройство проекта в каждой новой сессии, эти сведения стоит один раз положить в файл рядом с кодом — про это у меня отдельный разбор про CLAUDE.md и AGENTS.md.
Причина 2. ИИ-агент ошибается, когда его никто не проверяет
Второе правило — не доверять первому ответу. ИИ-агент ошибается молча: он не сообщит, что сомневается, и не поставит вопрос на полях.
Простейший приём: после выполнения задачи написать «проанализируй, всё ли сделал и что мог пропустить». Агент часто находит свои промахи и правит их сам. Работает, пока контекст не забит, — то есть ровно при соблюдении первого правила.
Приём посерьёзнее — прописывать критерии готовности прямо в задаче. Не «сделай форму заявки», а «форма отправляет данные в CRM, проверяет телефон, показывает ошибку при пустом поле и не разъезжается на ширине 375 пикселей». По такому чек-листу агент действительно сверяется.
И третье, чисто экономическое. Проверка агентом стоит копейки против часа работы человека, поэтому их можно ставить неприлично много. Там, где я постеснялся бы третий раз просить коллегу перечитать код, агента прошу в пятый раз без сомнений.
Как выглядит проверка на практике
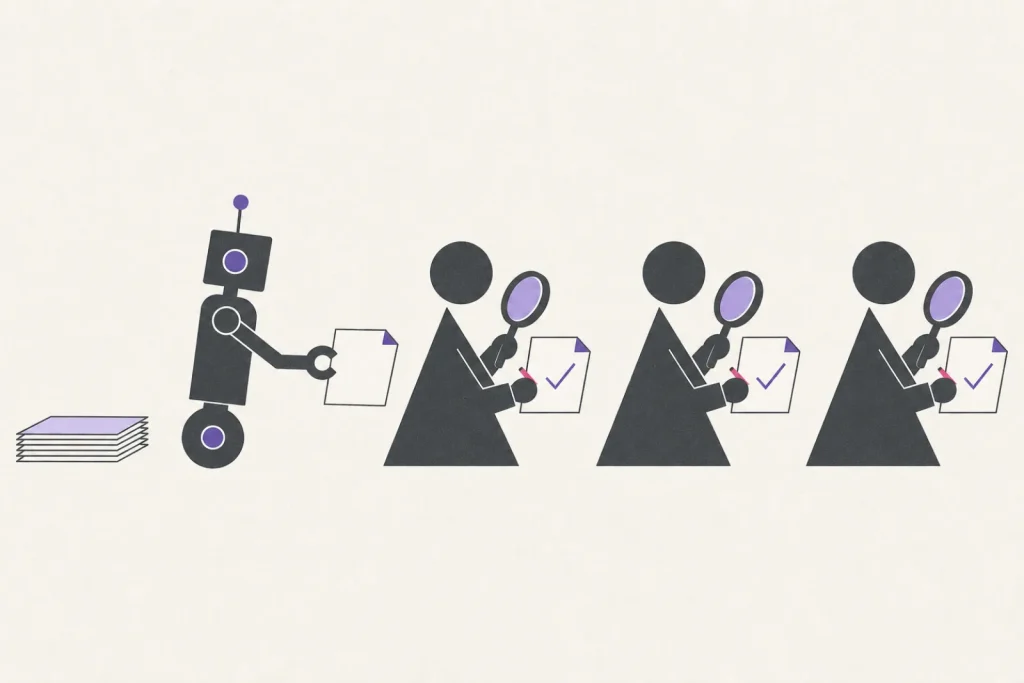
Схема простая. Задача сделана — открываю новую сессию и прошу покритиковать решение, не упоминая, что делал его тот же агент. В другой прошу сверить с критериями приёмки. В третьей — проверить, не сломается ли что-то на боевом сайте. В четвёртой — собрать замечания и составить план правок.
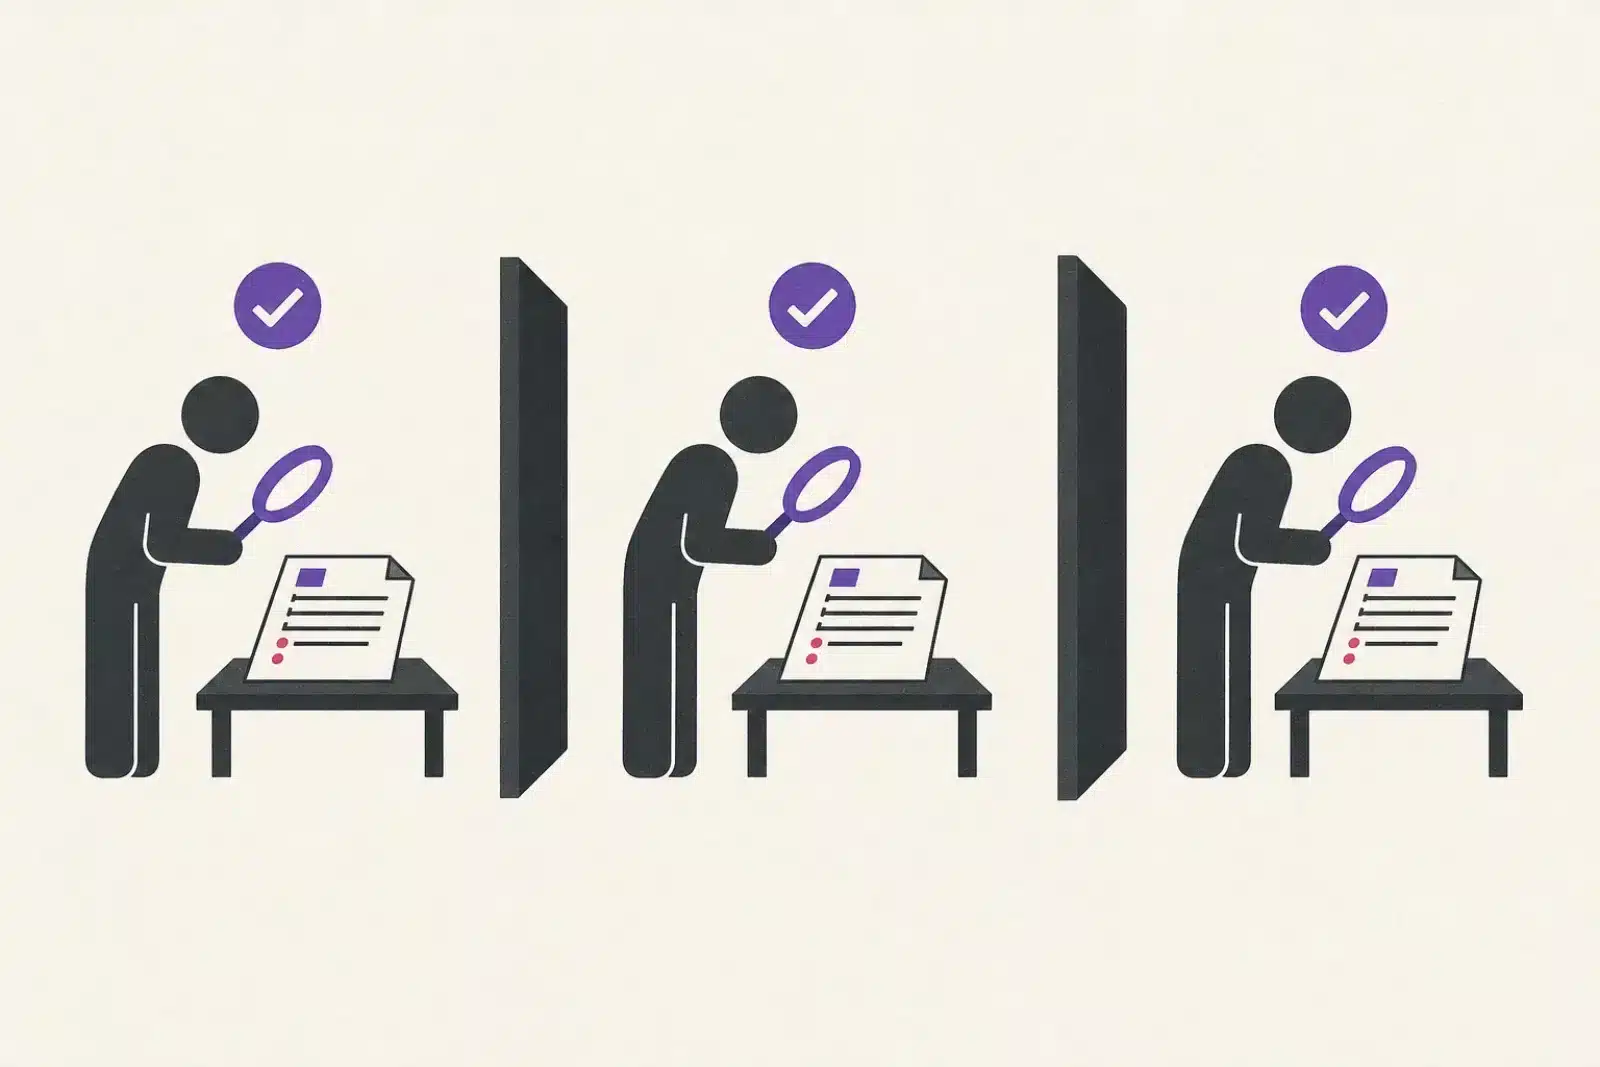
Каждая проверка идёт с чистого листа: проверяющий не наследует ход мыслей исполнителя и замечает то, что тот уже перестал видеть.
В Claude Code это автоматизируется: в план задачи включается требование вызвать субагентов-проверяльщиков с конкретными инструкциями, исправить найденное и позвать их ещё раз.
На AI Thumbnails Maker у меня стоит четыре таких проверяльщика: один смотрит на совместимость с версиями WordPress, второй ищет незакрытые санитайзеры на входных данных, третий сверяет код со стандартом WPCS, четвёртый проверяет, что строки для перевода не потерялись. Каждый работает в своей сессии и не знает, что писал предыдущий.
Именно четвёртый регулярно отлавливает то, что я бы пропустил: ИИ-агент ошибается на мелочи — правит текст в интерфейсе и забывает обернуть новую строку в функцию перевода. Огрех крошечный, но всплывает через месяц, когда приходит обновление локализации и половина строк остаётся английской.
Причина 3. ИИ-агент ошибается на задаче без критерия готовности
Бывает, что контекст короткий, проверки стоят, а результат всё равно плохой. Тогда ИИ-агент ошибается по третьей причине: задача сформулирована так, что её нельзя проверить.
«Сделай красиво», «оптимизируй», «почисти код» — под такими формулировками агент сам решает, что считать успехом, и всегда решает в свою пользу. Замените их на измеримое: «время загрузки страницы меньше двух секунд», «запросов к базе не больше шести», «линтер молчит». Проверяемая формулировка чинит больше, чем ещё один проверяльщик поверх невнятной.
Основная работа смещается в начало: я подолгу сижу над тем, как разбить задачу и по каким критериям принимать результат. Зато дальше запускаю и не вмешиваюсь — полчаса оно делается, проверяется, переделывается и выдаёт то, что не нужно перечитывать построчно.
Если ИИ-агент ошибается у вас постоянно, дело почти всегда в одном из трёх: вы дали ему слишком много, не дали способа себя проверить или поставили задачу без критерия готовности. Само устройство агента тут ни при чём — он делает ровно то, что позволяет постановка.


