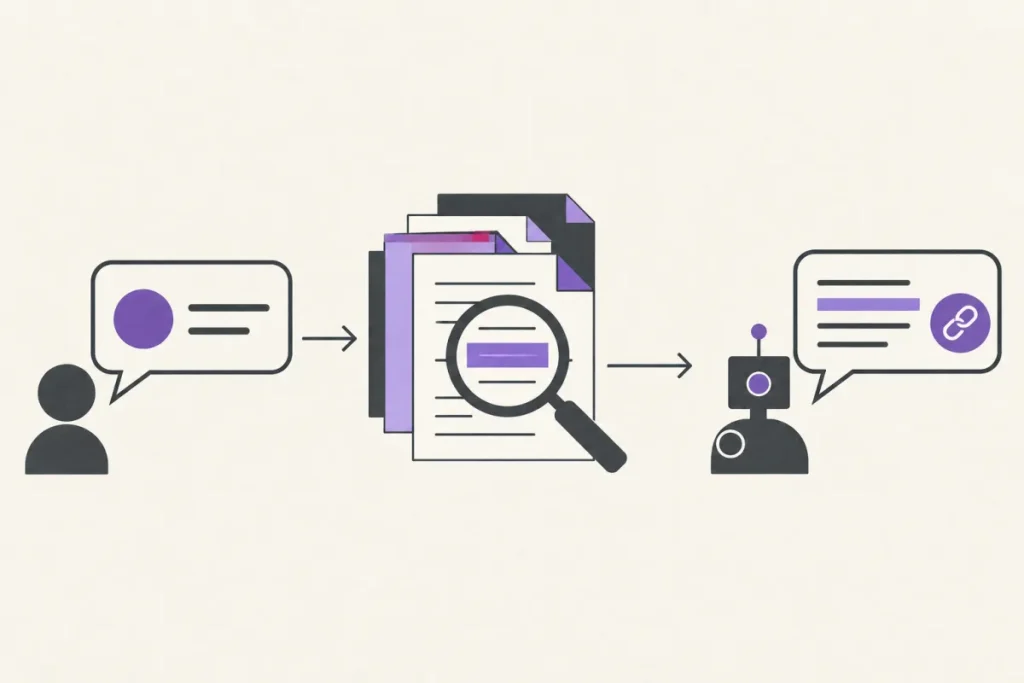
Пользователь WordPress-плагина пишет в поддержку: «Где взять API-ключ GigaChat и куда его вставить?» Обычная нейросеть ответит уверенно и почти наверняка неправильно: она не видела ни настроек плагина, ни страницы документации, где это расписано по шагам. Она придумает пункт меню, которого нет.
Бот с RAG поступит иначе. Сначала найдёт в документации страницу про ключ GigaChat, положит нужный фрагмент в запрос к модели и только потом ответит — по шагам и со ссылкой на источник. Модель та же самая, разница только в том, что ей показали перед ответом.
Ниже разберу, что такое RAG простыми словами, из чего состоит RAG-система, где она уже работает, почему ошибается и как внедрить её в компании за шесть шагов.
Что такое RAG простыми словами
RAG расшифровывается как Retrieval-Augmented Generation — генерация, дополненная поиском. Прежде чем отвечать, система ищет подходящие фрагменты в документах, на сайте или в интернете и передаёт их модели вместе с вопросом. Модель отвечает не по памяти, а по найденному.
Важно: RAG — это не отдельная нейросеть и не специальная модель. Это способ организовать работу вокруг любой языковой модели: сначала поиск, потом ответ. Поэтому RAG в ИИ собирают поверх ChatGPT, Claude, YandexGPT, GigaChat или открытой модели на своём сервере — устройство от этого не меняется.
Аналогия, которая хорошо объясняет суть: опытный сотрудник поддержки тоже не помнит наизусть все регламенты. На сложный вопрос он открывает базу знаний, находит нужный раздел и отвечает по нему. RAG делает то же самое, только за секунды и для тысяч вопросов подряд.
Почему нельзя просто дообучить модель
Первая мысль, которая приходит в голову: взять документы компании и дообучить на них модель. На практике это работает хуже, чем кажется. Дообучение хорошо меняет поведение — тон, формат, манеру отвечать, — но плохо закрепляет конкретные факты. Модель запомнит, «как обычно звучит ответ», а цифру из прайса может перепутать.
Вторая проблема — документы меняются. Прайс обновили во вторник, регламент поправили в четверг. Дообучать модель после каждой правки дорого и долго. В RAG-системе достаточно обновить документ в базе: следующий ответ уже будет по новой версии.
И третья — проверяемость. Дообученная модель не скажет, откуда взяла факт. RAG показывает источник: вот фрагмент, вот документ, вот ссылка. Ошибку можно найти и исправить, а не гадать, что модель «выучила».
Как работает RAG-система
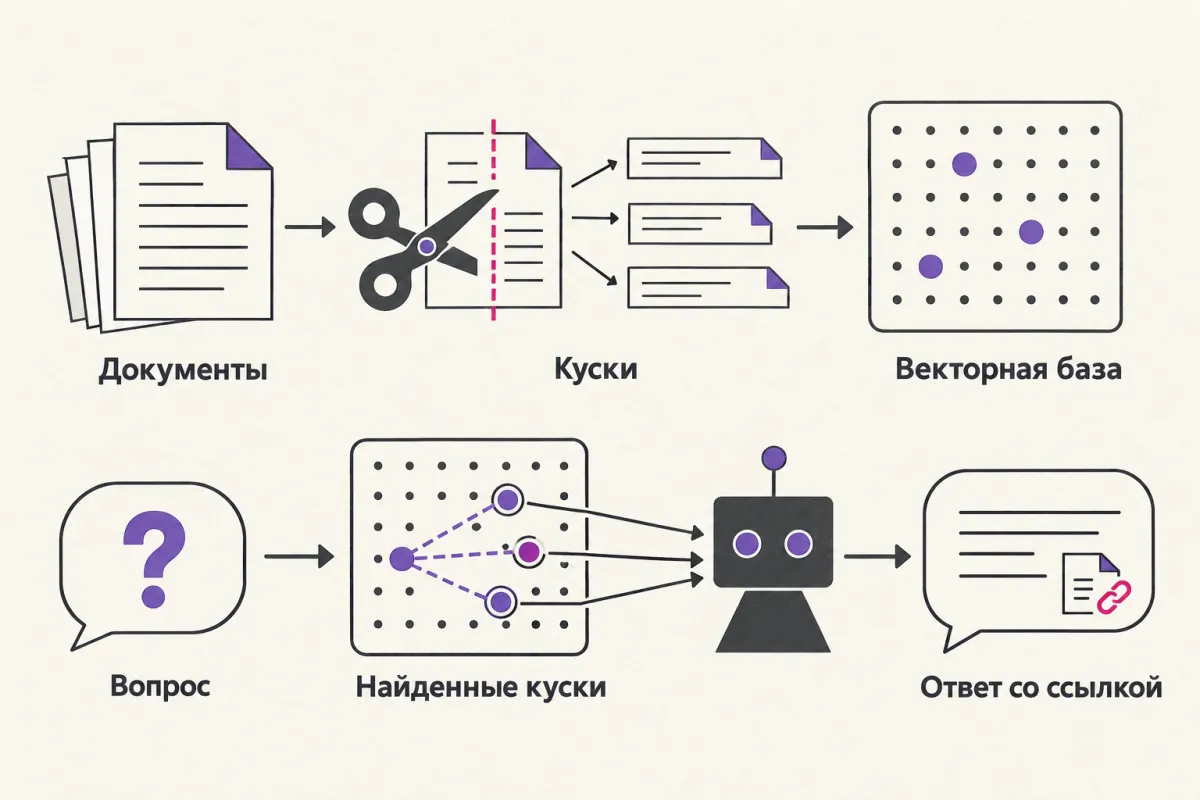
У любой RAG-системы два этапа. Первый — подготовка базы — делается заранее и повторяется, когда меняются документы. Второй — поиск и ответ — запускается на каждый вопрос.
Подготовка базы знаний
- Документы режут на куски. Целая страница документации или регламент на двадцать страниц слишком велики: смысл мелких деталей в них растворяется. Обычно кусок — это абзац или раздел на несколько сотен слов.
- Для каждого куска считают эмбеддинг — набор чисел, который описывает смысл текста. Куски с похожим смыслом получают похожие числа. Как это устроено, я подробно разбирал в статье про эмбеддинги простыми словами.
- Куски вместе с эмбеддингами складывают в векторную базу — хранилище, которое быстро находит ближайшие по смыслу фрагменты. К каждому куску приписывают метаданные: из какого документа, раздела, от какой даты.
Поиск и ответ на вопрос
- Вопрос пользователя переводят в эмбеддинг той же моделью, что и куски. Иначе вопрос и база окажутся на разных «картах» и сравнить их будет нельзя.
- Система находит несколько ближайших кусков — обычно от трёх до двадцати.
- Из вопроса и найденных кусков собирают запрос к модели: «Ответь, опираясь только на эти фрагменты. Если ответа в них нет — так и скажи».
- Модель пишет ответ и указывает, из какого документа взяла факт.
Искать, кстати, можно не только по эмбеддингам. Retrieval в названии означает просто «поиск»: по смыслу, по ключевым словам или обоими способами сразу. RAG описывает порядок действий, а не конкретную технологию поиска.
Сам термин появился в 2020 году в научной статье исследователей Facebook AI Research. Тогда модель обучали вместе с поиском по Википедии. Сегодня всё проще: готовую модель не трогают, а найденные фрагменты просто вставляют в запрос.
Из чего состоит RAG-система
На схеме всё выглядит просто, но в рабочей системе деталей больше. Их названия полезно знать, даже если собирать будет подрядчик: так проще понять его предложение и место, где система ломается.
| Часть | Что делает | Примеры |
|---|---|---|
| Загрузчик | Забирает текст из файлов, сайта, вики, распознаёт сканы | Скрипт по расписанию, коннекторы к Google Диску или Confluence |
| Нарезка | Делит документы на куски и приписывает метаданные | Куски по 300–800 слов с небольшим перекрытием |
| Модель эмбеддингов | Переводит куски и вопросы в числа | Модели OpenAI, Яндекса, открытые многоязычные модели |
| Векторная база | Хранит куски и находит ближайшие | Qdrant, pgvector в PostgreSQL, Chroma |
| Языковая модель | Пишет ответ по найденным кускам | GPT, Claude, YandexGPT, GigaChat, открытые модели |
| Системный промпт | Задаёт правила: отвечать только по документам, давать ссылки | Инструкция на полстраницы, которую правят по итогам тестов |
Эмбеддинги и ответ почти всегда делают разные модели. Модель эмбеддингов маленькая и дешёвая, она только сравнивает смысл. Языковая модель — большая, она пишет текст. Менять их можно независимо.
Виды RAG
Базовый RAG нашёл ближайшие куски и ответил — этого хватает для небольшой базы и простых вопросов. Продвинутый добавляет гибридный поиск, переформулирование вопроса и переранжирование: он нужен, когда документов много и они похожи друг на друга. GraphRAG строит граф связей между сущностями и отвечает на вопросы про картину целиком. Агентный RAG позволяет модели самой решать, где искать и сколько раз, — о нём в конце статьи.
Где вы уже пользуетесь RAG
Скорее всего, вы уже работали с RAG, просто это так не называлось.
Загрузка файлов в ChatGPT. Небольшой файл модель читает целиком. Если текста больше, чем помещается в контекст, ChatGPT ищет по файлу подходящие фрагменты и подкладывает их к вопросу.
Проекты в Claude. Пока файлов в проекте немного, Claude читает их полностью. Когда материалов становится слишком много, он переключается на поиск по ним — и в интерфейсе видно, как он ищет нужные фрагменты.
NotebookLM от Google. Отвечает только по загруженным источникам и под каждым утверждением ставит ссылку на фрагмент.
Поиск с нейросетью — Нейро, Perplexity. Здесь база знаний — весь интернет: система ищет страницы под ваш вопрос, а модель собирает из них ответ со ссылками.
Где RAG применяют в бизнесе
RAG-система окупается там, где много повторяющихся вопросов, а ответы лежат в документах.
- Поддержка клиентов — тарифы, условия, инструкции, ответы на частые вопросы. Бот закрывает простые вопросы, оператор получает только сложные.
- База знаний для сотрудников — регламенты, инструкции, внутренняя вики. Новичок спрашивает бота, а не отвлекает коллег.
- Техподдержка по документации — как в примере с плагином: пользователь спрашивает словами, бот отвечает по нужной странице.
- Продажи — менеджер спрашивает про характеристики, сроки поставки и совместимость товаров, бот отвечает по каталогу и прайсу.
- Юристы и закупки — поиск по договорам: сроки оплаты, штрафы, условия расторжения.
Почему RAG ошибается
RAG снижает число выдумок, но не убирает их совсем. Хороший пример — юридические ИИ-сервисы, которые ищут ответы по базе законов и судебных решений. В 2024 году исследователи из Стэнфорда проверили несколько таких сервисов: они ошибались в 17–33% ответов, причём иногда — со ссылкой на настоящий документ, в котором сказанного нет. Ссылка в ответе ещё не значит, что ответ верный.
Почему модели в принципе склонны к уверенным выдумкам, я разбирал в статье о том, почему нейросеть выдумывает факты. В RAG к этому добавляются свои причины, и большая часть сбоев случается ещё до того, как модель начала писать. Разберу их на том же боте поддержки по документации.
В базе нет ответа, а модель всё равно отвечает. Допустим, пользователь спрашивает: «Плагин работает с Midjourney?», а про Midjourney в документации ни слова. Но поиск не умеет возвращать пустоту — он всегда приносит самые похожие куски. Здесь это будет раздел про генерацию картинок через другие сервисы. Модель видит текст про картинки и может решить, что ответ где-то рядом. Лечится инструкцией: «если ответа в найденных фрагментах нет, так и скажи» — и тестами, которые это проверяют.
Поиск принёс похожий, но не тот кусок. В документации есть страница про ключ GigaChat и страница про ключ YandexGPT. По смыслу они почти одинаковые: «получите ключ в личном кабинете и вставьте в настройках». На вопрос про GigaChat поиск может поставить первой страницу Яндекса, и модель уверенно расскажет не тот порядок действий.
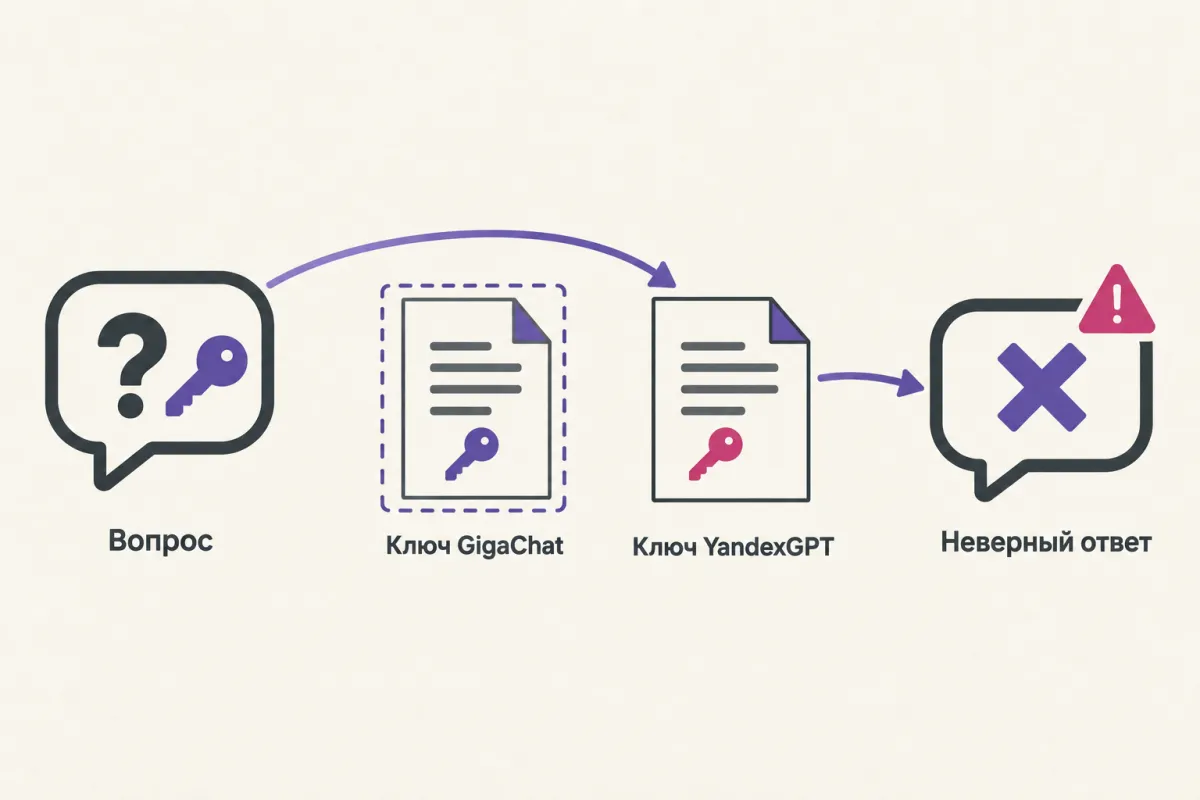
Нарезка оторвала оговорку от правила. Документ режут на куски механически, и граница может пройти посреди мысли. Допустим, в одном абзаце сказано, как вставить ключ, а в следующем — «для GigaChat нужен ключ авторизации, а не Client Secret». Второй кусок сам по себе непонятно о чём, на вопрос он не похож и в выдачу не попадает. Пользователь вставляет не тот ключ и получает ошибку.
В базе лежат две версии документа. Представьте: в прошлой версии плагина настройки были в одном меню, в новой — в другом, а старую страницу никто не удалил. Поиск принесёт обе, и модель выберет одну наугад или смешает их. Настройкой поиска это не лечится — только уборкой базы.
Нужный кусок нашёлся, а ответ всё равно неверный. Допустим, в документации написано «лимит сбрасывается в полночь по UTC», а модель отвечает «в полночь» и не уточняет часовой пояс. Такие ошибки ловят только тестами на реальных вопросах.
Как улучшают поиск в RAG-системе
Гибридный поиск ищет одновременно по смыслу и по точным словам, а потом объединяет результаты. Он нужен для названий настроек, артикулов, номеров договоров и кодов ошибок. Для поиска по смыслу «ошибка 401» и «ошибка 403» почти одно и то же, а поиск по словам найдёт именно нужный код.
Переранжирование — вторая, более внимательная проверка. Сначала быстрый поиск отбирает, скажем, двадцать кандидатов, потом отдельная модель читает вопрос вместе с каждым кандидатом и выстраивает их по тому, насколько кусок действительно отвечает на вопрос. Это дольше и дороже, поэтому включать его стоит после проверки на своих вопросах, а не по умолчанию.
Подпись к каждому куску лечит проблему оторванной оговорки. Перед сохранением к куску дописывают фразу о том, из какого он документа и о чём. «Для GigaChat нужен ключ авторизации» превращается в «Из инструкции по подключению GigaChat: для GigaChat нужен ключ авторизации» — и поиск понимает, к какому вопросу он относится. В исследовании Anthropic такой приём сократил число неудачных поисков на 49%, а вместе с переранжированием — на 67%.
Когда RAG не нужен
База маленькая. Если все документы — это десяток страниц, их проще целиком отдать модели в запросе. Современные модели держат в контексте сотни тысяч токенов, а с кэшированием повторные запросы с одной и той же базой стоят заметно дешевле. Правда, русский текст расходует токенов больше английского — почему, я объяснял в статье про токены в нейросети. И чем длиннее контекст, тем хуже модель замечает отдельные детали.
Нужно поменять стиль, а не знания. Если модель должна писать в тоне бренда или в строгом формате, RAG не поможет: он добавляет факты, а не меняет поведение. Это задача для подробной инструкции, примеров в запросе или дообучения.
| Задача | Что подходит |
|---|---|
| Ответы по большой базе документов, которая часто меняется | RAG |
| Несколько документов на десятки страниц | Загрузить целиком в запрос |
| Особый стиль, формат или тон ответов | Инструкция, примеры, дообучение |
| Свежие новости и цены из интернета | RAG с поиском по интернету |
Как внедрить RAG в компании: 6 шагов
Шаг 1. Выберите одну узкую задачу
Не начинайте с «бота, который знает всё о компании». Возьмите одну задачу, где вопросы повторяются, ответы есть в документах, а результат легко проверить. Например, ответы на вопросы клиентов по тарифам или ответы сотрудникам про отпуска и командировки. На одной задаче видно, работает ли подход, а расширить его потом несложно.
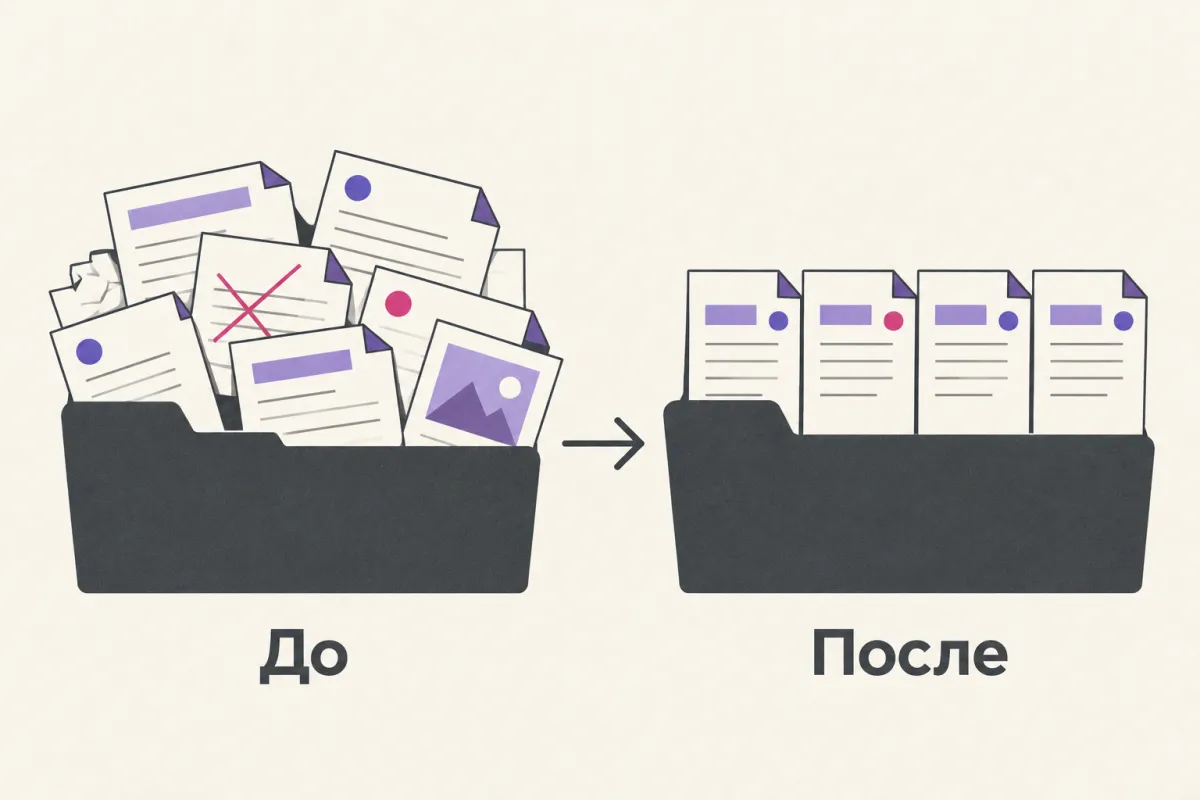
Шаг 2. Наведите порядок в документах
Качество ответов RAG упирается в качество базы. Хорошая модель по свалке файлов отвечает плохо.
- Одна тема — один документ с понятными заголовками. Заголовки помогают нарезке и поиску.
- Один актуальный экземпляр. Дубли и старые версии удалите или уберите в архив.
- Дата и ответственный в каждом документе — так видно, что устарело и кто обновит.
- Оговорки рядом с правилом, а не в отдельном файле «Исключения».
- Сканы — через распознавание. Картинка без текстового слоя для поиска пустая.
Шаг 3. Выберите готовый сервис или свою сборку
Собирать RAG с нуля нужно не всегда. Вариантов четыре.
Корпоративные тарифы ИИ-сервисов. В бизнес-тарифах ChatGPT, Claude и Gemini есть поиск по загруженным файлам и подключённым рабочим системам. Учтите, что официально из России эти сервисы не работают, а с персональными данными к ним вообще нельзя подходить без юриста.
Российские облачные сервисы. У Яндекса и Сбера есть сервисы, которые отвечают по загруженным документам. Это вариант, если данные должны храниться в России, а оплата — идти с российской карты.
Открытые решения на своём сервере. Open WebUI, AnythingLLM и Dify дают чат с базой знаний из коробки и работают с локальными моделями. Данные не покидают компанию, но поддерживать сервер придётся самим.
Своя сборка с ИИ-агентом. Если нужен бот в Telegram или на сайте, который ищет по вашей базе и отвечает со ссылками, его можно собрать с Claude Code или Codex. Код за вас напишет агент — от вас нужны подробное задание, доступы и тестовые вопросы. Как ставить задачу агенту, чтобы он не делал отсебятину, я описывал в статье про правила проекта для ИИ-агентов.
Шаг 4. Разберитесь с данными и доступами
Персональные данные. ФИО, телефоны и паспортные данные клиентов подпадают под 152-ФЗ. Закон требует хранить их в базах на территории России, а перед передачей за границу — уведомлять Роскомнадзор. Отправить такие документы в зарубежный ИИ-сервис — это и есть передача за границу.
Права доступа. Бот не должен отвечать стажёру цитатой из зарплатной ведомости. Поиск обязан учитывать, кто спрашивает: если сотрудник не может открыть документ сам, бот не должен отвечать по нему.
Шаг 5. Проверьте качество до запуска
Пара удачных ответов на демонстрации ничего не говорит о системе. Её проверяют на наборе тестовых вопросов:
- соберите двадцать реальных вопросов — из чата поддержки, почты, от сотрудников;
- для каждого запишите правильный ответ и документ, где он лежит;
- добавьте несколько вопросов, ответа на которые в базе нет: правильная реакция — «в документах этого нет»;
- проверяйте отдельно поиск и ответ: сначала — попал ли нужный кусок в найденные, потом — верен ли ответ;
- меняйте по одному параметру и прогоняйте тот же набор снова.
Шаг 6. Посчитайте стоимость
Деньги в RAG-системе уходят на три вещи. Эмбеддинги считаются один раз при загрузке и при обновлении документов — это дёшево. Хранение базы на тысячу страниц занимает меньше гигабайта. Основные расходы — генерация ответов: в каждый запрос уходят инструкция и несколько найденных кусков, то есть тысячи токенов на вопрос. Поэтому считать бюджет стоит от числа вопросов в день и цены выбранной модели, а модель выбирать по результатам тестов, а не по рекламе.
RAG и ИИ-агенты
Классический RAG ищет один раз: получил вопрос, нашёл куски, ответил. ИИ-агент может искать несколько раз подряд: посмотреть, что нашёл, переформулировать запрос, открыть другой документ и только потом ответить. Так работают режимы глубокого исследования в чат-ботах.
Интересный пример — Claude Code. Его разработчики рассказывали, что ранние версии использовали RAG с локальной векторной базой по коду, но агентный поиск — когда агент сам открывает и просматривает файлы проекта — оказался лучше и проще. Я сам пишу плагины с Claude Code и вижу, как он ищет: открывает файлы, ищет по названиям функций, идёт по ссылкам между ними, а не ждёт, что ему подложат нужный кусок.
Хоронить RAG из-за этого рано. Для агента поиск по смыслу — ещё один инструмент: он выручает, когда по точным словам ничего не находится. А подключить агенту поиск по вашей базе знаний можно через MCP — стандарт, по которому агенты получают доступ к внешним инструментам. Как такие агенты встраиваются в процессы компании, я разбирал в статье про ИИ-агентов для бизнеса.
Частые вопросы про RAG
Как расшифровывается RAG? Retrieval-Augmented Generation: retrieval — найти, augmented — дополнить запрос найденным, generation — написать ответ.
RAG — это модель? Нет. Это способ построить систему вокруг любой языковой модели. Одну и ту же модель можно использовать и с RAG, и без него.
RAG избавляет от галлюцинаций? Снижает их, но не убирает: модель может получить не тот кусок, не получить нужный или неправильно прочитать правильный.
Чем RAG отличается от дообучения? RAG даёт модели факты в момент вопроса и не меняет саму модель. Дообучение меняет модель и лучше подходит, чтобы закрепить стиль и формат ответов.
Обязательна ли векторная база? Нет. Искать можно и по ключевым словам. Векторная база нужна, чтобы находить текст по смыслу, когда вопрос сформулирован другими словами, чем документ. Для пары сотен документов хватит и обычного файла с эмбеддингами.
Можно ли внедрить RAG без программиста? Да, если хватает готового сервиса: загрузить документы в корпоративный чат-бот может любой сотрудник. Программист или ИИ-агент нужны, чтобы подключить базу к сайту или CRM, настроить права доступа или поднять систему на своём сервере.
Коротко
- RAG — это генерация, дополненная поиском: прежде чем ответить, система находит нужные фрагменты документов и отдаёт их модели вместе с вопросом.
- RAG-система работает в два этапа: база готовится заранее (нарезка, эмбеддинги, векторная база), поиск и ответ — на каждый вопрос.
- Большинство ошибок RAG — ошибки поиска: не тот кусок, оторванная оговорка, старая версия документа.
- Качество улучшают гибридный поиск, подписи к кускам, переранжирование — и тесты на реальных вопросах.
- Внедрять стоит с одной узкой задачи и с уборки документов; персональные данные и права доступа продумывают до запуска.


