Для своих сайтов я собираю карты ключевых слов: выгружаю частоты Wordstat в таблицу на несколько сотен строк и разбираю фразы по темам и будущим статьям. Нейросеть в такой работе полезна, но только в одной её части. Раскладывать фразы по смыслу она умеет хорошо. А сумму частот по теме может уверенно назвать, ничего не посчитав.
Так ведёт себя любая нейросеть для анализа данных: с текстом, классификацией и кодом она справляется, а цифры без кода может придумать. Ниже разберу, какие задачи стоит ей отдавать, где она опасна, какие инструменты есть на октябрь 2026 года — от анализа файлов в ChatGPT и Claude до функций в таблицах и локальных моделей, — как проверять результат и что делать с персональными данными по 152-ФЗ.
Что нейросеть делает в анализе данных хорошо
Языковая модель — это машина для работы с текстом. Чем больше в задаче смысла и чем меньше точной арифметики, тем лучше результат. Вот шесть задач, где помощь заметна.
1. Сводка по незнакомой таблице
Вам прислали выгрузку из CRM на 40 колонок, и непонятно, с чего начать. Нейросеть быстро опишет, что за столбцы в файле, где пропуски, какие значения выглядят странно, какие поля похожи на дубли. Это ещё не анализ, а разведка, но с неё удобно начинать.
2. Классификация отзывов и обращений
Самая сильная сторона языковых моделей. Пятьсот отзывов о доставке нейросеть разложит по темам — «опоздание», «холодная еда», «вежливость курьера», «упаковка» — и отметит тон каждого. Формулами такое не сделать, а вручную это долгая монотонная работа. Так же раскладываются обращения в поддержку, ответы из анкет и поисковые фразы.
3. Поиск закономерностей и гипотез
Нейросеть может заметить, что жалобы на опоздания растут по пятницам или что крупные заказы чаще приходят из одного района. Но относитесь к этому как к гипотезе. Пока за выводом не стоит расчёт, который можно открыть и проверить, это предположение, а не факт.
4. Формулы, запросы и регулярные выражения
Здесь нейросеть экономит время даже опытным людям. Опишите словами, что нужно — «сумма продаж по менеджеру за квартал, без возвратов», — и получите формулу для Excel или Google Таблиц, SQL-запрос или регулярное выражение. Проверить формулу проще, чем написать: подставьте её и сверьте пару строк вручную.
5. Графики
Нейросеть, которой доступно выполнение кода, строит графики по загруженным данным: столбчатые, линейные, круговые, точечные. Удобно, что можно попросить переделать подписи, цвета или группировку обычными словами, а не искать нужную галочку в настройках диаграммы.
6. Чистка данных
«ООО Ромашка», «Ромашка ООО» и «ромашка» — один клиент. Нейросеть хорошо приводит такие варианты к одному виду, разбирает адреса на части, исправляет опечатки в названиях городов. Только просите вернуть исходное и исправленное значение в соседних колонках, чтобы правку можно было проверить.
| Задача | Что даёт нейросеть | Где риск |
|---|---|---|
| Сводка по таблице | Быстрое понимание структуры | Может описать колонку по названию, не посмотрев на значения |
| Классификация текста | Темы и тон без ручной разметки | Разные ответы на одинаковые строки, размытые категории |
| Закономерности | Идеи, что проверить | Вывод без расчёта под ним |
| Формулы и запросы | Готовая формула по описанию | Не тот диапазон, не учтены пустые ячейки |
| Графики | Диаграмма по описанию словами | Неверная группировка или ось |
| Чистка данных | Единый вид названий и адресов | Склеит разных клиентов с похожими именами |
Где нейросеть опасна
Языковая модель генерирует текст по кусочку, токен за токеном. Число в её ответе — тоже текст: нейросеть пишет то, что правдоподобно смотрится на этом месте. Если она не запускала код, «итого 1 284 350 рублей» может быть просто похожим на правду числом. Почему модель вообще выдумывает и почему не говорит «не знаю», я подробно разбирал в статье о том, почему нейросеть выдумывает факты.
Сами разработчики об этом предупреждают. Яндекс в справке Таблиц пишет прямо: «Не используйте ИИ-функции для математических вычислений». Anthropic не рекомендует надстройку Claude для Excel для расчётов, критичных для аудита, без проверки. Google пишет, что функции Gemini могут предлагать неточную информацию. Вот типичные ошибки, которые встречаются в анализе данных с нейросетью:
- Выдуманная цифра. Нейросеть «посчитала» сумму, среднее или процент без кода. Выглядит уверенно, проверить не на чем.
- Прочитан не весь файл. OpenAI в справке оговаривает: файл может загрузиться, но оказаться слишком большим или сложным для полного анализа. Нейросеть ответит по той части, которую увидела, и не всегда об этом скажет.
- Не та колонка. В таблице «Сумма» и «Сумма без НДС», нейросеть взяла не ту. Или отфильтровала строки, о которых вы не просили.
- Сломанные типы. Дата 03.04 прочитана как 4 марта, десятичная запятая — как разделитель, числа с пробелами внутри — как текст.
- Таблица из картинки. Из сканов и скриншотов точные значения извлекаются ненадёжно — это тоже написано в справке OpenAI.
- Команды в чужом файле. В таблице от внешнего источника могут быть спрятаны инструкции для модели. Anthropic отдельно предупреждает, что так надстройку можно заставить вытащить данные или испортить записи.
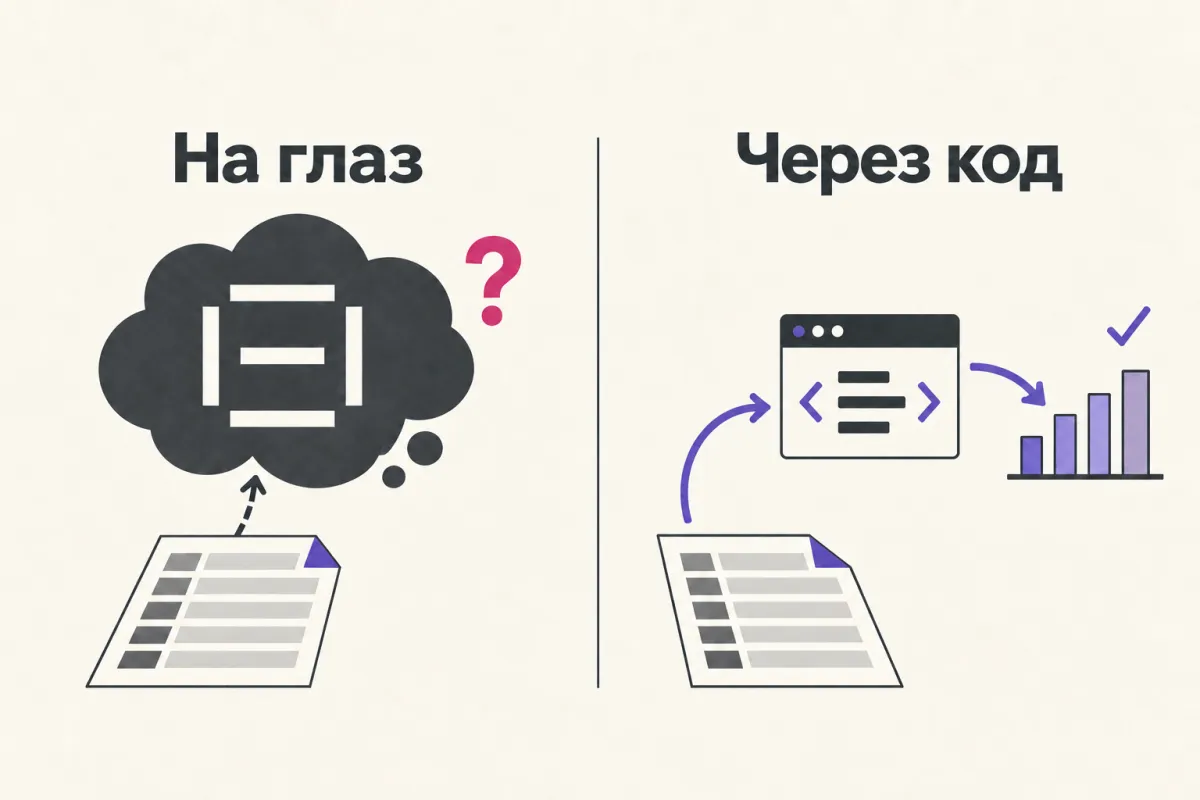
Два режима работы: «на глаз» и через код
Главное, что стоит понять про любой сервис: считает он кодом или «на глаз». В первом случае нейросеть пишет программу, например на Python, программа выполняется на реальных данных, и число в ответе — результат расчёта. Во втором нейросеть просто читает таблицу как текст и пишет ответ по памяти о прочитанном.
| «На глаз» | Через код | |
|---|---|---|
| Откуда берётся число | Нейросеть пишет его как текст | Его вычисляет программа |
| Можно ли проверить | Только пересчитав самому | Можно открыть код и увидеть, что посчитано |
| Большие таблицы | Чем больше строк, тем выше риск ошибки | Размер почти не влияет на точность |
| Где встречается | Обычный чат без инструментов, функции в ячейках | ChatGPT с анализом данных, Claude с выполнением кода |
Код тоже не гарантирует правильный ответ: программа может честно посчитать не ту колонку. Но такую ошибку видно. Поэтому первое правило — для любых сумм, средних и процентов просите считать кодом и показывать код. Если сервис код не выполняет, пусть даст формулу, а считает таблица.
Инструменты на октябрь 2026 года
ChatGPT: анализ данных
В справке OpenAI функция называется Data analysis. ChatGPT принимает таблицы XLS, XLSX и CSV, а также PDF, JSON, XML, TXT и другие текстовые форматы. Для части задач он пишет и запускает код на Python в среде Jupyter, показывает таблицы pandas в интерактивном виде и строит графики — интерактивными бывают столбчатые, линейные, круговые и точечные.
Ограничения из справки OpenAI о загрузке файлов: для таблиц и CSV лимит около 50 МБ на файл, загрузить можно до 80 файлов за 3 часа, на бесплатном тарифе — 3 файла в день. Среда с Python не выходит в интернет и не обращается к API, поэтому все данные нужно загрузить заранее.
Claude: выполнение кода и создание файлов
У Claude эта функция называется «Code execution and file creation». Код выполняется в изолированном контейнере. По справке Anthropic, функция доступна на всех тарифах, от Free до Enterprise, и включается в Settings → Capabilities. Claude принимает CSV, TSV и другие файлы с данными, строит графики в PNG и умеет создавать готовые файлы: таблицы XLSX, презентации, документы Word и PDF. Лимит — 30 МБ на файл.
Отдельно есть надстройка Claude for Excel для тарифов Pro, Max, Team и Enterprise. Она отвечает на вопросы по открытой книге со ссылками на конкретные ячейки, ищет причины ошибок вроде #REF!, меняет допущения, не ломая связи формул. Макросы и VBA надстройка не поддерживает.
Ни ChatGPT, ни Claude официально в России не работают: России нет в списках поддерживаемых стран ни у OpenAI, ни у Anthropic. OpenAI предупреждает, что за доступ из неподдерживаемой страны аккаунт могут заблокировать. Обходные пути я не описываю, ниже — законные варианты.
Функции нейросети прямо в ячейках
Второй способ — вызывать нейросеть формулой, по ячейке на строку. Это удобно для классификации и пересказа, но не для расчётов: функция работает «на глаз».
- Яндекс Таблицы — ИИ-функции. Формула
=ИИ("запрос"; A2)пересказывает, переводит, раскладывает по категориям, определяет тональность, извлекает данные и помогает составить формулу. Без тарифа Яндекс 360 действует лимит 50 запросов в месяц. Для математики Яндекс использовать их не советует. - Google Таблицы — функция AI. Синтаксис
AI("запрос", [диапазон]), задачи те же: генерация, пересказ, категории, тональность. Ответ только текстом, весь лист функция не видит, за раз заполняются первые 350 ячеек. Нужен подходящий тариф Google Workspace или Google AI. Работает функция на Gemini, а России нет в списке стран, где официально доступно приложение Gemini. - Excel — функции COPILOT больше нет. С 14 сентября 2026 года Microsoft убрала её из Excel. Старые результаты остаются в книге как сохранённые значения, а при пересчёте формула вернёт
#NAME?. Вместо неё Microsoft предлагает панель Copilot в Excel.
Российские сервисы
В обычный чат «Алисы AI» можно прикрепить один файл DOC, DOCX, PDF или TXT до 100 МБ — таблиц в этом списке нет. Таблицы XLS и XLSX до 300 МБ принимает режим «Задачи» в «Алисе AI» для бизнеса, и там же модель умеет создавать XLSX.
GigaChat через API принимает документы, в том числе XLSX, до 40 МБ, а содержимое модель получает встроенной функцией get_file_content, то есть читает файл как текст. Выполнения кода для анализа в документации я не нашёл. Форматы стоит проверять заранее: например, CSV в списке форматов документов GigaChat нет, так что таблицу лучше отправлять в XLSX.
Локальные модели для чувствительных данных
Если данные нельзя отдавать наружу, нейросеть можно запустить на своём компьютере. Самые простые способы:
- Ollama — программа для запуска открытых моделей на macOS, Windows и Linux, есть образ для Docker. Лицензия MIT.
- LM Studio — приложение с окном чата. С июля 2025 года бесплатно и дома, и на работе.
Из открытых моделей для анализа подойдут, например, gpt-oss от OpenAI и свежие Qwen. По официальному репозиторию, gpt-oss-20b помещается в 16 ГБ памяти, а лицензия Apache 2.0 разрешает коммерческое использование. У Qwen3.8-27B, вышедшей в августе 2026 года, тоже Apache 2.0.
Ограничение локального варианта: такая нейросеть сама код не выполняет. Она напишет скрипт, а запускать его придётся вам — или через программу, где модель подключена к среде выполнения. По качеству рассуждений небольшие локальные модели обычно уступают облачным флагманам, поэтому проверять их ответы нужно ещё внимательнее.
| Инструмент | Таблицы | Считает кодом | Официально из России |
|---|---|---|---|
| ChatGPT, анализ данных | XLS, XLSX, CSV | Да, Python | Нет |
| Claude, выполнение кода | CSV, TSV, XLSX | Да, в контейнере | Нет |
| Яндекс Таблицы, ИИ-функции | Ячейки таблицы | Нет | Да |
| Google Таблицы, функция AI | Ячейки таблицы | Нет | Gemini — нет |
| «Алиса AI» для бизнеса, режим «Задачи» | XLS, XLSX | В справке не описано | Да |
| GigaChat API | XLSX как документ | В документации не описано | Да |
| Локальная модель через Ollama или LM Studio | Что прочитает ваш скрипт | Код запускаете вы | Да, данные не уходят с компьютера |
Мой пример: карта ключевых слов из Wordstat
Вернусь к задаче из начала. Карта ключевых слов — это таблица, где у каждой поисковой фразы есть частота, тема и статья, под которую она пойдёт. Такие карты в CSV я делал для своих сайтов. Исходник — выгрузка из Wordstat: на вкладке «Топы запросов» сервис показывает данные за последний месяц и даёт скачать их в CSV.
Возьмём живой кусок. Вот частоты по теме этой статьи, выгруженные в октябре 2026 года, и темы, которые для них подобрала бы нейросеть:
| Фраза | Частота | Тема |
|---|---|---|
| нейросеть для анализа данных | 1450 | общий запрос |
| лучшая нейросеть для анализа данных | 435 | выбор сервиса |
| бесплатная нейросеть для анализа данных | 94 | бесплатные варианты |
| нейросети для анализа данных курс | 53 | обучение |
| нейросеть для анализа данных в excel | 36 | таблицы |
| нейросети для анализа данных нетология | 17 | обучение |
| топ нейросетей для анализа данных | 13 | выбор сервиса |
Разложить фразы по темам нейросеть может отлично. А вот на следующем шаге её легко поймать. Попросите посчитать спрос по теме «выбор сервиса», и нейросеть вполне может сложить 435 и 13. Но Wordstat считает число запросов, содержащих фразу. Значит, 435 запросов со словом «лучшая» уже входят в 1450 общего запроса, и складывать вложенные фразы с общей нельзя — спрос посчитается дважды.
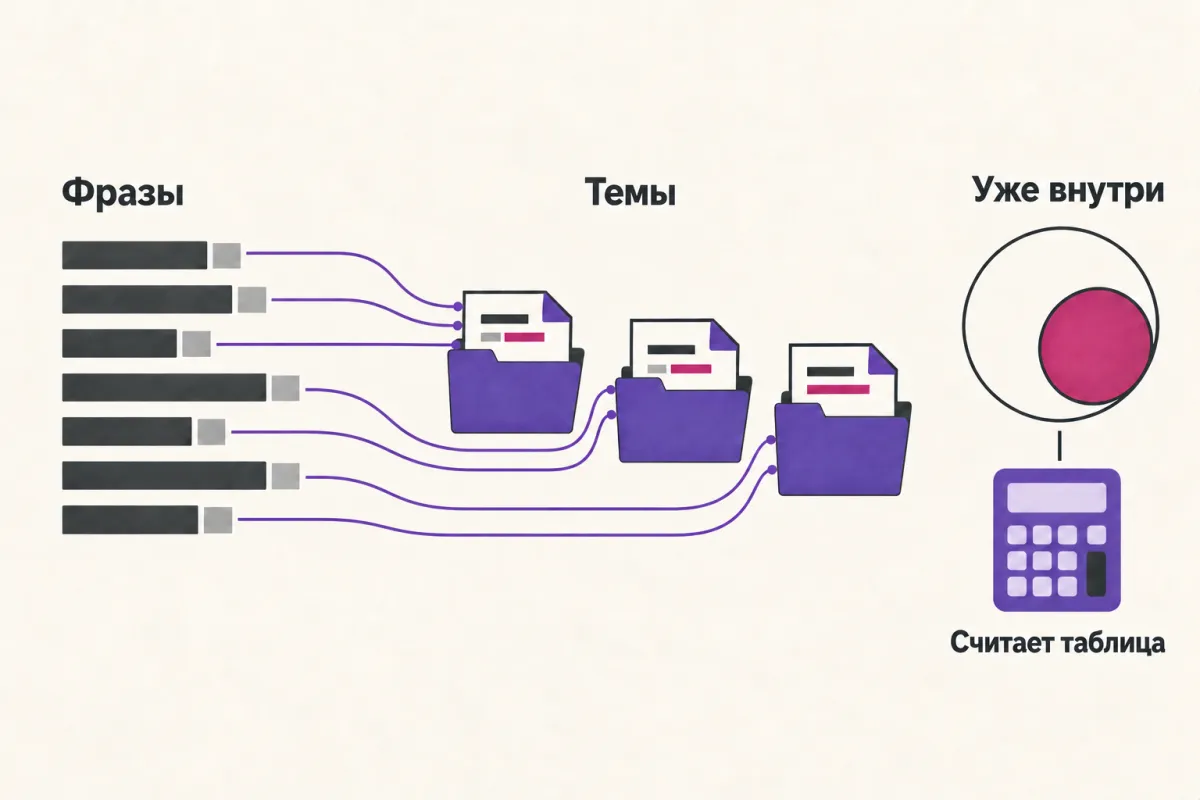
Поэтому я делю работу так: смысл — модели, арифметика — таблице. Порядок, который я бы советовал:
- Оставьте в таблице две колонки: фраза и частота. Лишние колонки только путают модель.
- Задайте список тем сами, а не просите модель их придумать. Добавьте тему «другое» — иначе нейросеть натянет сомнительные фразы на существующие темы.
- Попросите вернуть таблицу с теми же строками и одной новой колонкой. Сразу сверьте число строк на входе и на выходе.
- Частоты по темам считайте формулой или сводной таблицей, а не в чате. И помните про вложенность: для оценки спроса берите самую общую фразу темы, а не сумму всех.
- Просмотрите 20 случайных строк глазами. Если ошибок больше одной-двух, уточните описания тем и прогоните ещё раз.
Ниже таблица поисковых фраз в формате CSV: фраза;частота.
Присвой каждой строке ровно одну тему из списка:
выбор сервиса, бесплатные варианты, таблицы, обучение, общий запрос, другое.
Верни CSV с колонками фраза;частота;тема.
Количество и порядок строк не меняй, частоты не трогай.
Если сомневаешься — ставь «другое».
Для длинных списков, на тысячи фраз, удобнее другой путь: не отправлять всё в чат, а сгруппировать фразы по эмбеддингам — числовым векторам смысла. Как это устроено, я объяснял в статье про эмбеддинги простыми словами. Модели тогда остаётся дать понятные названия готовым группам.
И последний шаг, на котором карта превращается в статьи, — выбор главного ключа. Здесь я однажды наткнулся на особенность, которую нейросеть сама не подскажет. Когда настраивал SEO-модуль, выяснил, что Rank Math считает ключ точной фразой, без учёта падежей. Поэтому в русском тексте плотность ключа из трёх-четырёх слов почти не набирается, и надёжнее короткий ключ в именительном падеже.
Как проверять результат
Проверка занимает меньше времени, чем исправление ошибочного отчёта, который уже ушёл руководителю. Вот проверки в порядке от самых дешёвых к самым надёжным.
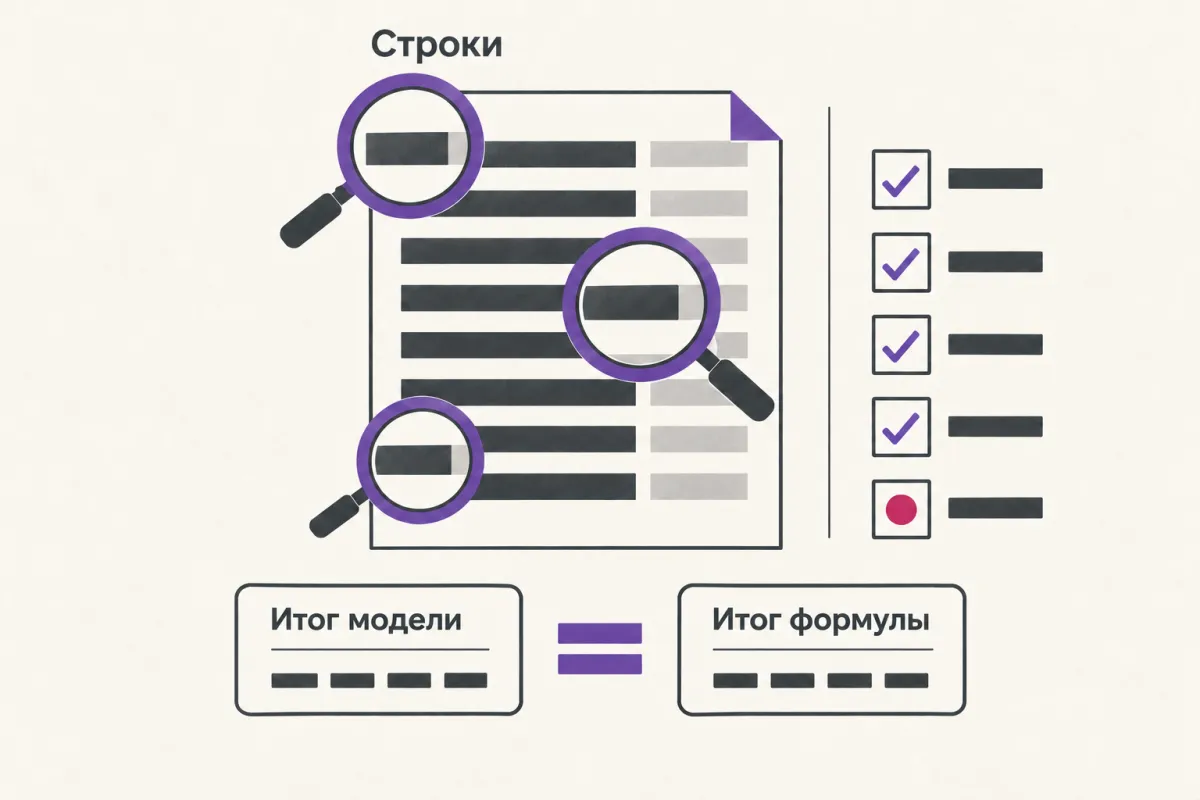
- Число строк. Сколько строк было, сколько обработано, сколько исключено и почему. Если нейросеть молча выбросила пустые строки или дубли, вы должны об этом знать.
- Контрольная сумма. Посчитайте общий итог сами одной формулой и сравните с итогом модели. Расхождение даже на одну строку — повод разбираться.
- Код или формула. Попросите показать код, которым посчитан результат, и прочитайте хотя бы фильтры: какие колонки взяты и какие строки отброшены.
- Выборочная проверка. Для классификации — 20 случайных строк вручную. Для чистки — все строки, где исправленное значение сильно отличается от исходного.
- Пересчёт другим способом. Тот же итог через сводную таблицу. Совпало — хорошо, не совпало — ищите, кто ошибся.
- Повторный прогон. Запустите ту же классификацию ещё раз. Если нейросеть раздала половине строк другие темы, категории описаны размыто.
- Цифры под выводом. На каждую закономерность просите расчёт: сколько строк, какой процент, за какой период. Вывод без цифр под ним — это гипотеза.
Отдельный совет для больших таблиц. Я пишу плагины с Claude Code каждый день и привык к простому правилу: код, который можно перезапустить, надёжнее ответа в чате. Для таблицы на десятки тысяч строк попросите не ответ, а скрипт, который посчитает и сохранит результат в файл. Тогда расчёт можно повторить завтра на новых данных и получить тот же результат тем же способом.
И следите за объёмом. У модели есть предел текста, который она держит в голове за один запрос, и большая таблица, вставленная прямо в чат, может в него не влезть целиком. Как модель меряет текст, я разбирал в статье про токены в нейросети.
Персональные данные и 152-ФЗ
Типичная ошибка — загрузить в нейросеть выгрузку клиентов как есть, с именами, телефонами и адресами. По 152-ФЗ персональные данные — это любая информация, которая прямо или косвенно относится к конкретному человеку. Имя с телефоном, номер заказа с адресом, переписка с клиентом — всё это они.
Если файл с такими данными уходит в зарубежный сервис, это трансграничная передача. По части 3 статьи 12 закона оператор обязан уведомить Роскомнадзор о намерении её вести до того, как начнёт. Кроме того, с 1 июля 2025 года действует новая редакция части 5 статьи 18: при сборе персональных данных граждан России их запись, систематизация, накопление и хранение с использованием баз за пределами страны не допускаются, исключения перечислены в законе.
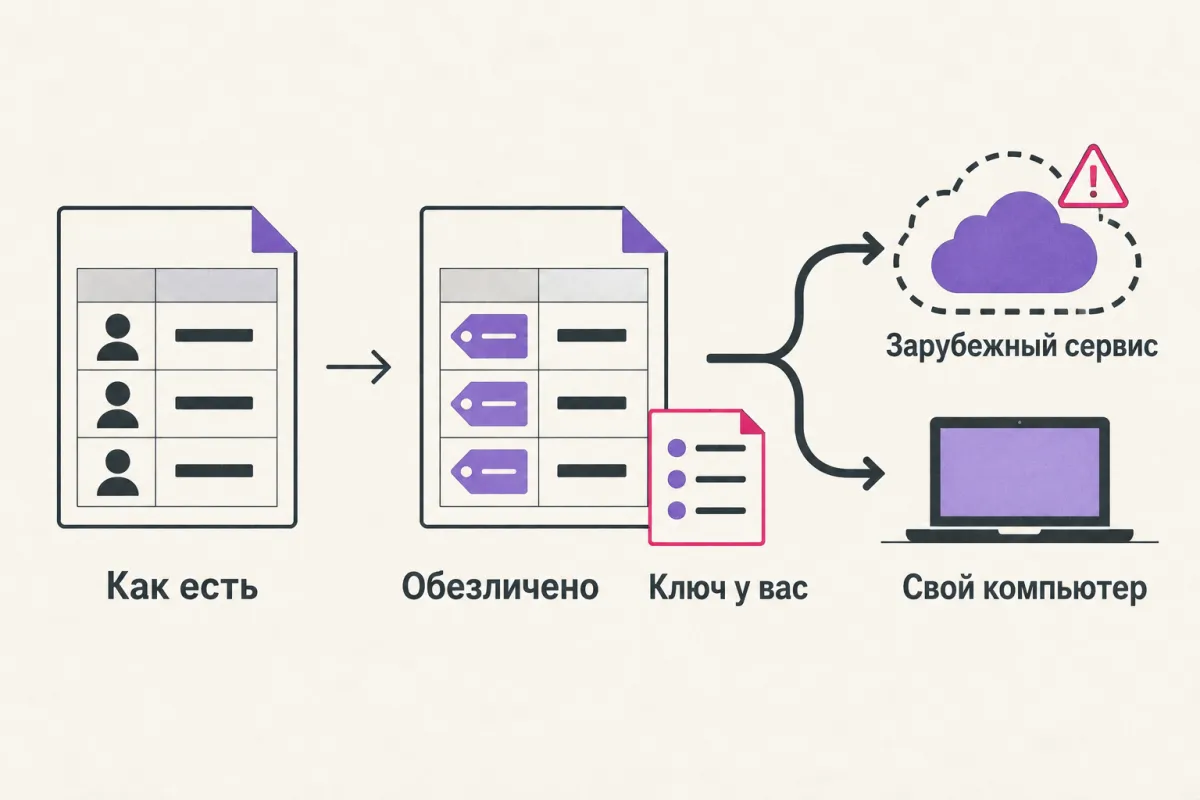
На практике для анализа почти никогда не нужны сами имена и телефоны. Нужны суммы, даты, категории, тексты отзывов. Поэтому самый простой путь — обезличить данные до загрузки. В законе обезличивание определено как действия, после которых без дополнительной информации нельзя понять, к какому человеку относятся данные.
- Замените имена и телефоны на номера: «Клиент 1», «Клиент 2». Таблицу соответствия номеров и людей держите у себя.
- Уберите колонки, которые для задачи не нужны: email, адрес, паспортные данные.
- Почистите тексты отзывов и переписки: люди часто пишут в них свои имена и телефоны.
- Если можно, отдавайте не строки, а уже сгруппированные данные: продажи по дням, а не по клиентам.
- Если без персональных данных задачу не решить, используйте локальную модель — данные не покинут ваш компьютер.
Это не юридическая консультация. Если вы оператор персональных данных и регулярно обрабатываете их с помощью нейросетей, согласуйте порядок с юристом.
Частые вопросы
Какая нейросеть лучше для анализа данных?
Та, что считает кодом и которой вы законно можете отдать свои данные. Для таблиц с цифрами важнее выполнение кода, чем «ум» модели. Для классификации текстов подойдут и функции в ячейках. Для данных клиентов — локальная модель или полностью обезличенный файл.
Есть ли бесплатная нейросеть для анализа данных?
Да. Ollama и LM Studio с открытыми моделями бесплатны. В Яндекс Таблицах ИИ-функции работают без тарифа в пределах 50 запросов в месяц. У Claude выполнение кода есть и на бесплатном тарифе, а бесплатный ChatGPT принимает 3 файла в день, но оба сервиса официально в России недоступны.
Как использовать нейросеть для анализа данных в Excel?
Функцию COPILOT Microsoft из Excel убрала в сентябре 2026 года, вместо неё — панель Copilot. Claude for Excel работает как надстройка на платных тарифах Claude. Самый простой путь без надстроек — описать задачу словами в любом чате, получить формулу и вставить её в ячейку: считать будет сам Excel.
Коротко
- Нейросеть хорошо понимает смысл: классифицирует отзывы и фразы, чистит названия, пишет формулы и код, строит графики.
- Числа без кода — это текст, который модель написала по памяти. Для сумм и процентов просите считать кодом или формулой и показывать, как посчитано.
- Анализ файлов в ChatGPT и Claude считает на Python, но официально в России оба сервиса недоступны. Законные варианты — ИИ-функции Яндекс Таблиц, сервисы Яндекса и Сбера, локальные модели через Ollama или LM Studio.
- Проверка начинается с простого: число строк, контрольная сумма одной формулой, 20 случайных строк вручную.
- В картах ключевых слов частоты Wordstat вложены друг в друга, поэтому складывать их нельзя: темы — модели, арифметика — таблице.
- Данные клиентов перед загрузкой в зарубежный сервис обезличьте. Трансграничная передача по 152-ФЗ требует уведомить Роскомнадзор, а хранить базы граждан России за рубежом закон не позволяет.


