Проверка текста на нейросеть обычно выглядит так: вы вставляете статью в детектор, он показывает «87% — ИИ», и начинается спор. Автор уверяет, что писал сам, заказчик требует переделать или вернуть деньги. Короткий ответ на этот спор: процент детектора — вероятность, а не доказательство. OpenAI в 2023 году закрыла собственный детектор из-за низкой точности, а Яндекс прямо называет выводы своего «Нейродетектора» рекомендацией.
Ниже — как устроен детектор ИИ-текста и почему он ошибается на текстах людей, что известно о водяных знаках в текстах моделей на октябрь 2026 года, что официально говорят об ИИ-контенте Google и Яндекс и как редактору понять, что текст сгенерирован, не опираясь на процент. Я смотрю на тему с двух сторон: я сам делаю плагин, который пишет статьи нейросетью, и мне важно, как такие тексты проверяют.
Как работает детектор ИИ-текста
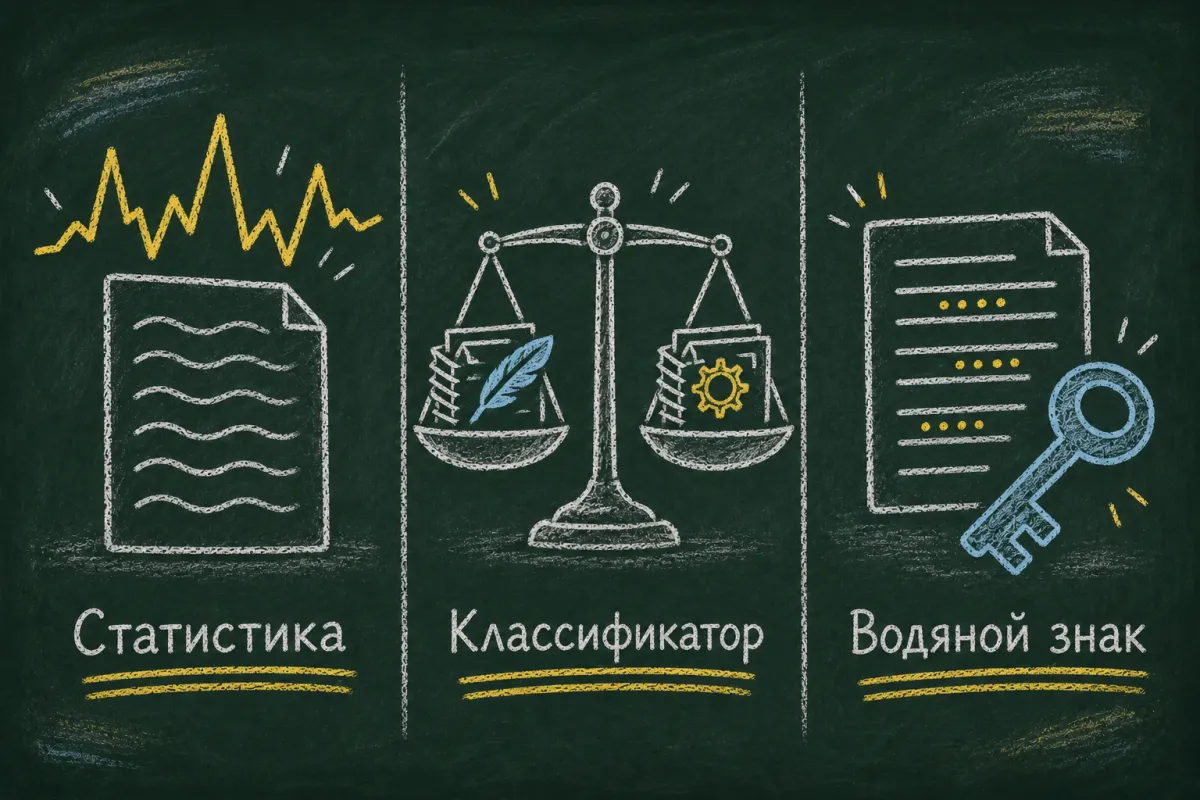
Детектор не знает, кто написал текст. Он оценивает, насколько текст похож на то, что обычно пишут модели. Подходов три, и у каждого свои слабые места.
Статистика: насколько предсказуемы слова
Языковая модель пишет, на каждом шаге выбирая вероятное продолжение. Отсюда идея: взять другую модель и посчитать, насколько предсказуемо каждое слово проверяемого текста. Машинный текст окажется «гладким», человеческий — неровным. Эти мерки называют перплексией и «взрывностью» (burstiness): первая показывает предсказуемость слов, вторая — насколько она скачет от предложения к предложению.
С этого начинал, например, GPTZero. Но в его справке сказано, что с осени 2023 года сервис эти метрики для определения больше не использует и перешёл на модель глубокого обучения. Слабость метода понятна и без объяснений: предсказуемым бывает и человеческий текст — инструкция, справка, сочинение по плану.
Классификатор: модель, обученная отличать
Второй подход — обучить модель на парах «человеческий текст — машинный текст на ту же тему», чтобы она сама нашла различия. Так был устроен классификатор OpenAI 2023 года. На обученной модели работает и нынешний GPTZero. Слабость — данные обучения. OpenAI, выпуская свой классификатор, предупреждала: на текстах, непохожих на обучающие, он иногда крайне уверен в неверном ответе.
Водяной знак: метка от самой модели
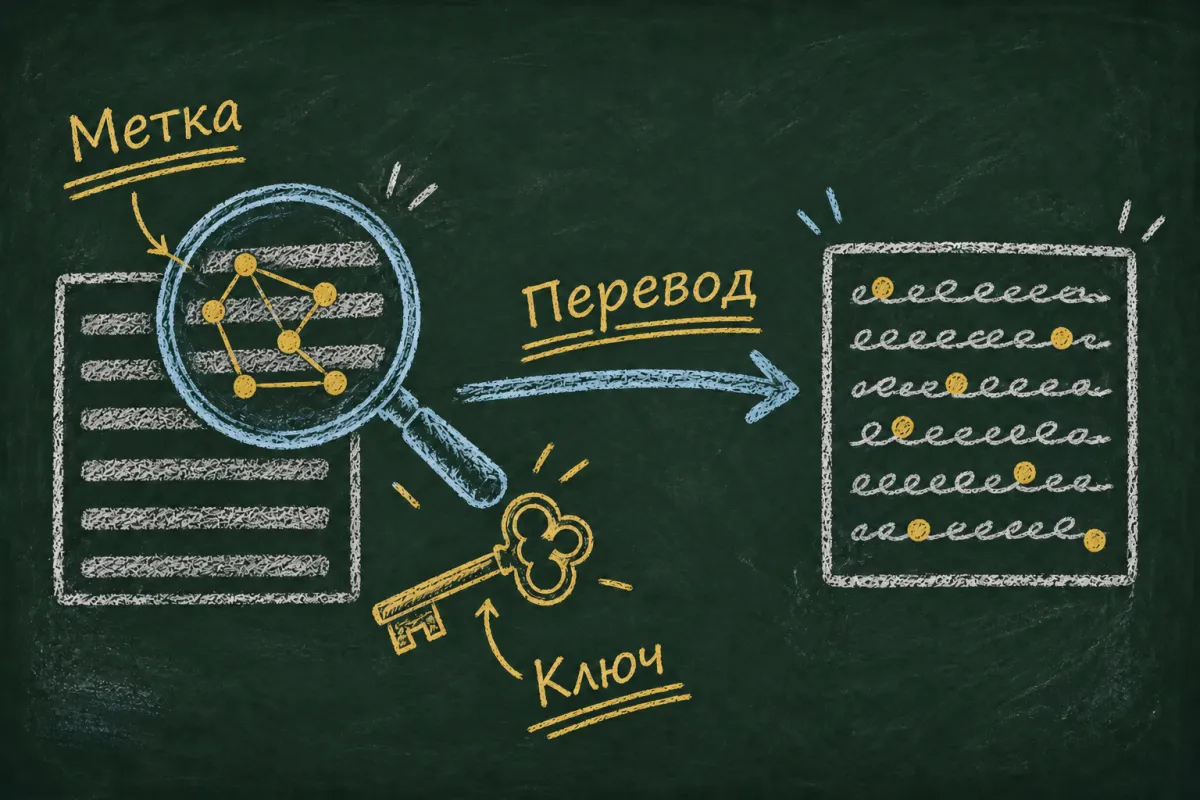
Третий подход устроен иначе. Разработчик модели при генерации чуть подправляет выбор слов по секретному ключу. Для читателя текст не меняется, но в нём остаётся статистический узор, который находит детектор с тем же ключом. Такой детектор не гадает по стилю, а ищет конкретную метку — но видит только модели своей компании и только там, где метку включили.
| Подход | Как работает | Где ошибается |
|---|---|---|
| Статистика | Считает, насколько предсказуемы слова | Простые и шаблонные тексты людей, короткие фрагменты |
| Классификатор | Модель, обученная на парах «человек — ИИ» | Тексты, непохожие на обучающие, другие языки, правка после генерации |
| Водяной знак | Ищет метку, которую поставила модель | Короткие и сильно переписанные тексты, перевод, модели без метки |
| Спросить чат-бота «это ты написал?» | Никак | Всегда: OpenAI пишет, что ответы ChatGPT на такой вопрос случайны |
Почему OpenAI закрыла свой детектор
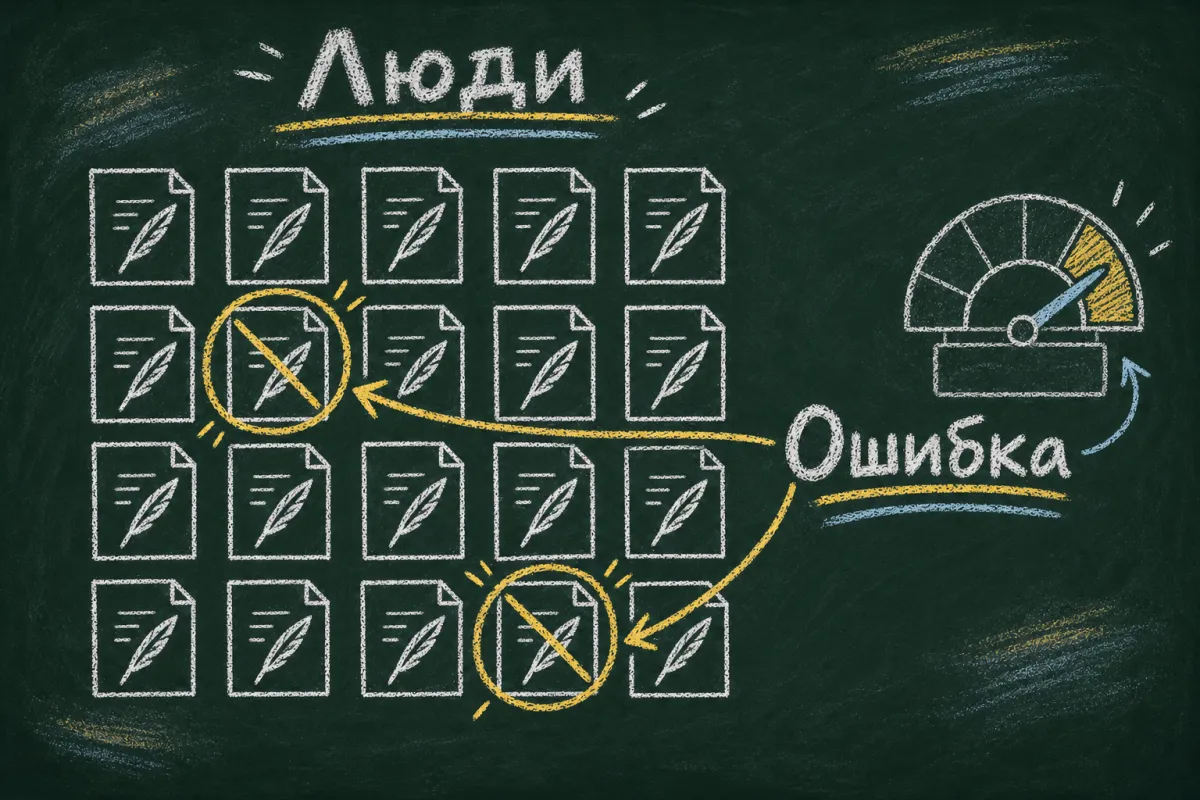
В январе 2023 года OpenAI выпустила классификатор, который должен был отличать текст ИИ от человеческого. Уже в анонсе компания писала, что он ненадёжен. На проверочном наборе английских текстов он верно помечал как «вероятно, ИИ» лишь 26% машинных текстов и при этом в 9% случаев ошибочно приписывал ИИ человеческие.
Там же перечислены ограничения. На текстах короче 1000 символов классификатор «очень ненадёжен», на других языках работает заметно хуже, чем на английском, а машинный текст можно отредактировать так, чтобы обойти проверку. 20 июля 2023 года OpenAI отключила его, сославшись на «низкий уровень точности».
Позже в справке для преподавателей OpenAI ответила на вопрос, работают ли детекторы ИИ, ещё короче: «In short, not in our experience» — по опыту компании, нет. Там же рассказано, что их экспериментальный детектор принял за творение ИИ тексты Шекспира и Декларацию независимости США. А ChatGPT, по словам OpenAI, «не знает», какой текст сгенерирован, и на вопрос «это ты написал?» отвечает наугад.
Почему детектор ошибается на текстах людей
Ложное срабатывание — когда детектор называет машинным текст, который написал человек. Для автора это самая неприятная ошибка, и у неё несколько типичных причин.
- Короткий текст. Чем меньше слов, тем меньше материала для статистики. У классификатора OpenAI порогом были 1000 символов, и та же зависимость от длины видна у водяных знаков — о них ниже.
- Шаблонный жанр. Инструкция, протокол, описание товара, юридический текст предсказуемы по природе — и у человека, и у модели. OpenAI писала, что очень предсказуемый текст надёжно определить нельзя.
- Неродной язык и простой слог. Авторы исследования «GPT detectors are biased against non-native English writers» проверили популярные детекторы на текстах людей, для которых английский не родной. Детекторы систематически принимали их тексты за машинные. OpenAI тоже упоминает этот риск — и для авторов с «формульным» или сжатым стилем.
- Не тот язык. Классификатор OpenAI на неанглийских текстах работал заметно хуже. Как конкретный сервис ведёт себя на русском, проверяйте сами — на текстах, автор которых вам точно известен.
- Смешанное авторство. Человек написал черновик, модель поправила, человек переписал. Ни один процент не скажет, чья это работа. Anthropic прямо пишет, что даже её водяной знак не отличает «написал Claude» от «Claude сильно отредактировал».
- Правка после генерации. Обратная ошибка: машинный текст после редактуры проходит проверку как человеческий. По словам OpenAI, небольших правок хватает, чтобы обойти детектор.
Добавьте сюда то, что детекторы между собой не согласованы: каждый обучен на своих данных и по-своему выставляет порог. Поэтому один и тот же текст в разных сервисах может получить разные оценки, и выбрать «правильную» из них нельзя.
Что значат 9% ложных срабатываний на практике
Девять процентов звучат терпимо, пока не посчитать. Допустим, редакция за месяц проверяет 200 статей, и все написаны людьми. При такой доле ошибок детектор обвинит примерно 18 честных авторов. OpenAI делает похожее замечание про водяные знаки: даже при низкой доле ложных срабатываний на большом объёме текстов их общее число получается большим.
Водяные знаки: что известно на октябрь 2026 года
Водяные знаки в тексте долго оставались темой исследований, а в 2026 году стали практикой. Причина — европейский закон об ИИ. Статья 50 AI Act требует, чтобы системы, создающие синтетический текст, изображения, звук или видео, маркировали результат в машиночитаемом виде, чтобы его можно было распознать как сгенерированный. По словам Anthropic, требование действует со 2 августа 2026 года, а для систем, выпущенных раньше, закон даёт переходный период.
Google: SynthID
Google DeepMind маркирует технологией SynthID тексты, которые генерируют приложение и веб-версия Gemini. Версия для текста выложена в открытый доступ: её можно подключить к своей модели через библиотеку Hugging Face Transformers начиная с версии 4.46.0. В документации SynthID Text честно перечислены ограничения: на фактических ответах метка ставится хуже, а после тщательного переписывания или перевода уверенность детектора сильно падает.
OpenAI: textGrain, только в Евросоюзе
5 октября 2026 года OpenAI рассказала о своей технологии textGrain. Метку добавляют в тексты ChatGPT и Codex в Евросоюзе — постепенно, в течение нескольких недель после анонса. В API она по умолчанию выключена, но клиенты в любой стране могут включить её сами. Детектор пока доступен только одобренным исследователям и экспертным организациям.
OpenAI опубликовала и цифры. При целевой доле ложных срабатываний 1% детектор находил метку примерно в 80% фрагментов длиной 200 токенов и примерно в 95% фрагментов на 400 токенов — на текстах вроде ответов по психологии. На математике результаты заметно хуже: там у модели меньше свободы в выборе слов. Замена 10% слов синонимами снижала долю найденных меток примерно с 92% до 66%, замена 25% — до 17%. Что такое токены и почему длина считается в них, я разбирал в статье про токены в нейросети.
Anthropic: метка во всех текстах Claude
Anthropic пошла дальше: метку получают тексты поддерживаемых моделей Claude по всему миру, а не только в ЕС. Компания объясняет это тем, что пока не умеет надёжно ограничить метку регионом. Модели, вышедшие после 2 августа 2026 года, маркируют текст с первого дня, а для более ранних метку добавляют постепенно. Метод основан на той же технике, что и SynthID-Text от Google DeepMind.
Проверить текст на метку Claude обычный пользователь пока не может: API детектора в закрытом тестировании и доступен регуляторам, СМИ, фактчекерам, исследователям, образовательным организациям и компаниям, которым проверка нужна по закону. Сама Anthropic в разборе своего водяного знака подчёркивает: метка говорит лишь о том, что Claude, вероятно, участвовал в создании текста.
| Компания | Метка в тексте | Какие тексты | Кто может проверить |
|---|---|---|---|
| SynthID | Приложение и веб-версия Gemini; открытая версия — для своих моделей | Google; для своей модели — открытый детектор | |
| OpenAI | textGrain | ChatGPT и Codex в ЕС; в API — если клиент включил | Одобренные исследователи и экспертные организации |
| Anthropic | Метка на технике SynthID-Text | Поддерживаемые модели Claude по всему миру | Закрытый тест: регуляторы, СМИ, фактчекеры, исследователи |
А что в России? В законе об ИИ № 243-ФЗ от 26 июля 2026 года статья 9 говорит об «информационном предупреждении» для материалов в аудио- и визуальной форме, созданных большими фундаментальными моделями: человеку должны дать возможность его разместить. О текстах в этой статье ничего нет, а вступает она в силу с 1 марта 2027 года.
Главное для редактора: водяной знак — полезный сигнал, но не детектор на все случаи. Метку ставят не все модели, её стирают перевод и плотная правка, проверка в основном закрыта. И, как пишет OpenAI, отсутствие метки не доказывает, что текст написал человек.
Что говорят об ИИ-контенте Google и Яндекс
Владельцу сайта важнее не то, распознают ли поисковики ИИ-текст, а то, как они к нему относятся. Обе системы говорят по сути одно: оценивают качество, а не способ производства.
В блоге Google Search Central ещё в феврале 2023 года появился ответ: «Appropriate use of AI or automation is not against our guidelines» — уместное использование ИИ и автоматизации правила не нарушает. Нарушение — генерировать контент в первую очередь ради манипуляции ранжированием. В правилах о спаме это называется злоупотреблением масштабированным контентом, и среди примеров — генерация множества страниц с помощью ИИ без пользы для читателя.
На отдельной странице о генеративном ИИ Google добавляет практическое требование. Модели не извлекают факты, а предсказывают вероятные слова, поэтому всё сгенерированное нужно вручную проверить на точность до публикации — включая title, description, микроразметку и alt у картинок. Там же Google советует рассказывать читателю, как создавался контент, если тот может задаться этим вопросом.
Яндекс
Яндекс в блоге для вебмастеров в марте 2025 года написал, что точность определения низкокачественных документов, включая созданные с помощью ИИ, выросла до 99%. И тут же оговорился: «само по себе использование нейросетей не является негативным фактором, если публикуемый контент — качественный, проверен экспертом, не вводит пользователя в заблуждение и действительно помогает ему решить свой вопрос».
Годом раньше, в марте 2024-го, Яндекс описывал некачественный контент как спам-материалы, в том числе созданные автоматически, без дополнительной ценности, с бессмысленными фрагментами и без проверки людьми. Ни одна из формулировок не наказывает за сам факт генерации. Наказывают за бесполезность и за то, что текст никто не проверил.
Как понять, что текст сгенерирован: 5 шагов без процента детектора
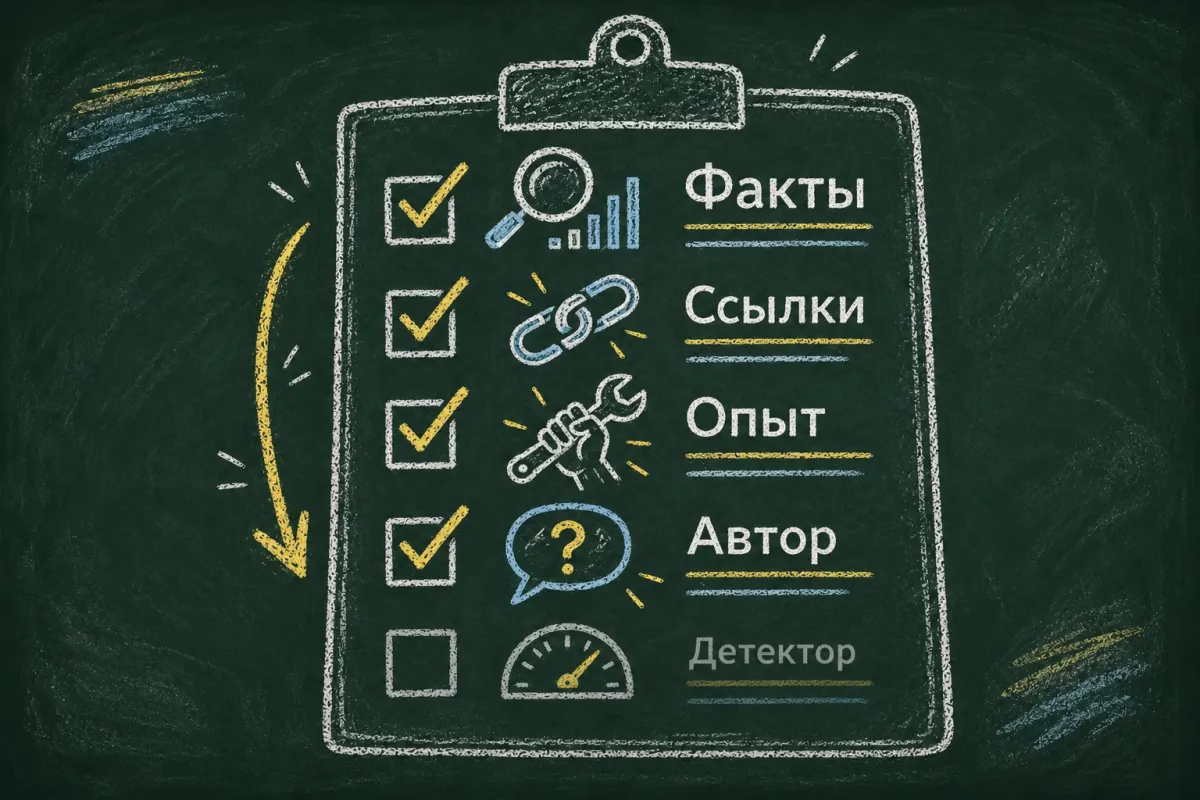
Если процент — не доказательство, на что опираться? Редактору полезнее другой вопрос: не «кто написал», а «можно ли это публиковать». На него отвечают проверка фактов и внимательное чтение. Вот пять шагов в том порядке, который я советую.
1. Проверьте факты
Это главный и самый надёжный признак. Модель пишет правдоподобно, но может уверенно сослаться на несуществующее исследование, перепутать год, придумать цитату или ссылку. Выберите в тексте пять-семь проверяемых утверждений — цифры, даты, названия, цитаты — и найдите для каждого первоисточник. Если два-три не находятся вовсе, неважно, кто писал: текст не готов.
Отдельно откройте ссылки: работают ли они и говорит ли страница то, что ей приписано. Почему модели выдумывают и где это случается чаще всего, я подробно разбирал в статье «Почему нейросеть выдумывает факты».
2. Ищите конкретику и опыт
Сгенерированный текст часто знает тему «в общем»: правильные слова, но ни одного случая, цифры из собственной практики, версии инструмента, оговорки вроде «у нас это не сработало, потому что…». Спросите себя: мог ли это написать человек, который ни разу не делал того, о чём пишет? Если да, тексту не хватает опыта, а именно опыт ценят и Google, и Яндекс.
3. Читайте внимательно: стилевые признаки
У моделей есть любимые обороты, и разработчики это признают. Anthropic упоминает, что модели любят конструкцию «это не X, это Y» и подозрительно часто употребляют слово «quietly». OpenAI в руководстве к GPT-6 приводит список слов и приёмов, от которых советует модель отучать, — включая ту же конструкцию «This isn’t about X. It’s about Y» и итоговые фразы вроде «Bottom line:».
В русских текстах аналоги узнаются быстро:
- противопоставление «дело не в X, а в Y» в каждом втором абзаце;
- вступление о том, как быстро всё меняется, и вывод, который пересказывает сказанное;
- тройки прилагательных и перечисления ровно по три пункта;
- одинаковая длина абзацев и предложений по всему тексту;
- уверенный тон без единой оговорки или сомнения;
- общие слова там, где ждёшь цифру или пример.
Но это признаки, а не улики. Так пишут и люди — особенно те, кто учился по шаблонам или много читает сгенерированного. Стилевые признаки — повод внимательнее проверить факты, но не основание для вердикта.
4. Поговорите с автором
Если сомнения остались, задайте автору пару вопросов по тексту: откуда эта цифра, почему выбран этот пример, что он сам думает о спорном месте. Человек, который разбирался в теме, ответит за минуту. Попросите черновики или источники. Это работает лучше любого сервиса и не портит отношений так, как обвинение по проценту.
5. Детектор — последним и только как сигнал
Если пользуетесь детектором, то так: проверяйте длинные фрагменты, а не абзац; прогоните через тот же сервис пару текстов, автор которых вам точно известен, чтобы понять, как он ошибается на вашем жанре; не принимайте решений только по проценту. Ровно так позиционирует свой «Нейродетектор» Яндекс: в анонсе для преподавателей сказано, что его выводы выступают «только в качестве рекомендации» и указывают на работы, требующие внимания.
| Что проверить | Как | Что настораживает |
|---|---|---|
| Факты | Пять-семь утверждений, первоисточник для каждого | Источник не находится или говорит другое |
| Ссылки | Открыть каждую | Ссылка битая или ведёт не туда |
| Опыт | Есть ли случаи, цифры, оговорки из практики | Только общие слова |
| Стиль | Прочитать пару абзацев вслух | Одинаковый ритм, штампы, тройки |
| Автор | Пара вопросов по тексту | Не может объяснить, откуда факт |
| Детектор | Длинный фрагмент, сравнение с текстами известного авторства | Только как повод проверить внимательнее |
Взгляд с другой стороны: я делаю генератор статей
Я сам делаю бесплатный плагин для WordPress SmartyPress AI Engine, который пишет статьи нейросетью. Поэтому вопрос «как сделать, чтобы детектор не узнал» я понимаю, но считаю его неверно поставленным. Детектор спорит со стилем, а редактор и поисковик — с содержанием.
Ещё одно наблюдение из моих тестов: модели бывают уверены в том, чего не делали. GigaChat-2 в моих испытаниях в сентябре 2026 года сообщала о работе, которую на самом деле не выполняла. В статье это выглядит так же: гладкое «по данным исследования…» без исследования. Поэтому проверка фактов у меня в списке первая.
Теперь про водяные знаки. Если текст пишет поддерживаемая модель Claude, метка в нём уже есть: Anthropic ставит её на уровне модели, в том числе для запросов через API, и заложена она в сам выбор слов. У OpenAI в API метка по умолчанию выключена. А при лёгкой правке вашего абзаца нейросетью метке почти не за что зацепиться: Anthropic пишет, что после такой правки почти все слова остаются авторскими.
Мой вывод как автора генератора: делать нужно не текст, «невидимый для детектора», а текст, который выдерживает проверку редактора, — с фактами, источниками и опытом. К такому тексту у поисковика нет претензий, а процент детектора перестаёт быть аргументом.
Если детектор обвинил ваш текст
- Не спорьте с процентом — спорьте фактами: покажите черновики, заметки, историю правок в редакторе, источники.
- Предложите прогнать через тот же детектор ваш старый текст, написанный до массового прихода нейросетей. Если и он окажется «машинным», аргумент снимается сам.
- Сошлитесь на позицию разработчиков: OpenAI закрыла свой классификатор из-за низкой точности и пишет, что детекторы, по её опыту, не работают.
- Если текст правда правили моделью, скажите об этом прямо и объясните, что сделали сами: собрали факты, проверили, переписали.
Частые вопросы
Можно ли доверять бесплатной проверке текста на нейросеть онлайн? Как подсказке — да, как доказательству — нет. Бесплатные и платные детекторы опираются на одни и те же подходы и ошибаются по одним и тем же причинам: короткий текст, шаблонный жанр, правка, другой язык.
Есть ли проверка текста на нейросеть у Яндекса? В марте 2025 года Яндекс Образование запустило для преподавателей «Нейродетектор» в личном кабинете: он подсвечивает работы, которые могли быть сгенерированы. Сам Яндекс называет его выводы рекомендацией, а не вердиктом.
Может ли ChatGPT сказать, написал ли он текст? Нет. OpenAI прямо пишет, что у ChatGPT нет «знания» о том, какой текст сгенерирован, и его ответы на такие вопросы случайны.
Чем проверка на нейросеть отличается от антиплагиата? Антиплагиат ищет совпадения с уже опубликованными текстами, детектор — признаки генерации. Сгенерированный текст может быть уникальным для антиплагиата, а переписанный у коллеги — «человеческим» для детектора. Это проверки на разные вопросы.
Понизят ли Google или Яндекс сайт за ИИ-тексты? За сам факт генерации — нет, это следует из их официальных заявлений выше. За массовые бесполезные и непроверенные страницы — да, но так же, как и за написанные людьми.
Нужно ли помечать текст, написанный нейросетью? Статья 9 российского закона 243-ФЗ говорит только об аудио- и визуальных материалах. В ЕС статья 50 AI Act требует раскрывать ИИ-происхождение текстов, опубликованных для информирования о вопросах общественного значения, если их не проверял редактор, который за них отвечает. Google советует пояснять, как сделан контент, когда читатель может об этом спросить.
Коротко
- Детектор ИИ-текста выдаёт вероятность, а не доказательство: OpenAI закрыла свой классификатор в 2023 году из-за низкой точности.
- Ложные срабатывания на текстах людей — обычное дело: короткие и шаблонные тексты, неродной язык, смешанное авторство.
- В 2026 году водяные знаки в тексте стали реальностью у Google, OpenAI (в ЕС) и Anthropic, но проверка в основном закрыта, а перевод и плотная правка метку стирают.
- Google и Яндекс оценивают качество и пользу, а не способ написания, и наказывают за бесполезный массовый контент.
- Редактору надёжнее проверить факты, ссылки и опыт автора и поговорить с ним, чем верить проценту.


