AI-разработчик — это программист, который встраивает готовые нейросети в продукты: подключает модели через API, даёт им данные компании, собирает агентов и проверяет, что ответы верные и не съедают бюджет. Модели с нуля AI-разработчик не обучает — это работа ML-инженера.
Допустим, интернет-магазину нужен помощник, который отвечает покупателям про доставку и не выдумывает сроки. Сама модель уже есть. Задача AI-разработчика — подать ей правила магазина, связать с базой заказов, ограничить в действиях и доказать тестами, что она отвечает правильно.
Я делаю такую работу в собственном продукте — бесплатном плагине для WordPress SmartyPress AI Engine, который пишет статьи нейросетью: подключаю к нему модели разных компаний, настраиваю ИИ-агента и проверяю его поведение автотестами. Ниже — чем AI-разработчик отличается от ML-инженера и вайбкодера, что он делает руками, какие нужны навыки, сколько платят по данным hh.ru и Хабр Карьеры и с чего начать портфолио. Данные — на октябрь 2026 года.
Кто такой AI-разработчик
Единого названия у профессии нет: похожую работу называют «AI-инженер», «LLM-инженер», «разработчик AI-агентов» или просто «Python-разработчик» со строчкой про нейросети в требованиях. В статье карьерной платформы hh.ru о девяти направлениях работы в ИИ такой роли тоже нет: ближе всего ML-инженер и NLP-инженер, а LLM-инженер упомянут как вариант развития.
Суть у всех этих названий одна. AI-разработчик берёт модель, которую уже обучили OpenAI, Anthropic, DeepSeek, Сбер или Яндекс, и делает из неё работающую часть продукта: чат-бота, поиск по документам, генератор описаний, агента, который сам выполняет шаги задачи.
Что AI-разработчик делает руками
- Интеграции с API моделей. Ключи, форматы запросов, потоковые ответы, повторы при ошибках, переключение между провайдерами.
- Поиск по своим данным (RAG). Нарезка документов, эмбеддинги, поиск нужного фрагмента и подача его модели вместе с вопросом.
- Агенты. Описание инструментов, которые модель может вызывать, ограничения прав и проверка того, что агент сделал заявленное.
- Тесты качества. Наборы сценариев, по которым после каждой правки промпта или смены модели видно, стало лучше или хуже.
- Учёт стоимости. Сколько стоит один запрос, один диалог и месяц работы — до запуска, а не после первого счёта.
- Данные и безопасность. Какие данные можно отправлять зарубежному провайдеру, как не дать модели выполнить чужую команду из текста документа.
AI-разработчик, ML-инженер и вайбкодер: в чём разница
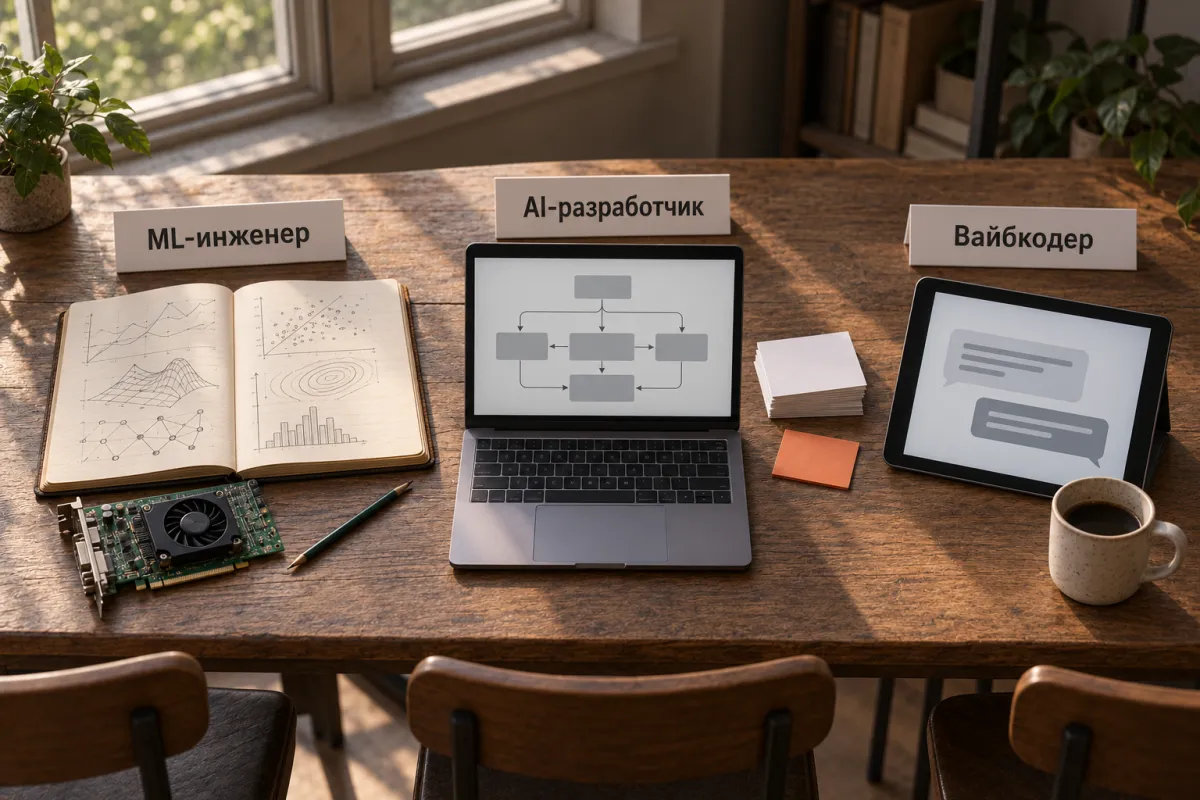
Три роли часто путают, потому что все три работают с нейросетями. Разница — в том, что каждая из них производит и за что отвечает.
| Роль | Чем занят | Результат работы | Без чего не обойтись |
|---|---|---|---|
| ML-инженер | Обучает и дообучает модели на данных, подбирает алгоритмы, следит за метриками | Модель с измеренной точностью | Математика, статистика, фреймворки обучения |
| AI-разработчик | Строит продукт на готовых моделях: интеграции, поиск по данным, агенты, тесты, стоимость | Работающий сервис с понятным качеством и ценой | Программирование, API, базы данных, оценка ответов |
| Вайбкодер | Описывает задачу агенту для кода и принимает результат, почти не читая код | Прототип или небольшая программа | Умение ставить задачу и проверять результат |
| Промпт-инженер | Пишет и проверяет инструкции для моделей | Набор промптов под задачи бизнеса | Понимание моделей и предметной области |
Граница плавает. AI-разработчик сам постоянно пишет промпты и сам пользуется агентами для кода: я, например, пишу плагины в Claude Code каждый день. Но вайбкодер отвечает за то, чтобы программа заработала, а AI-разработчик — за то, как она ведёт себя на тысячах реальных запросов: сколько ошибается, сколько стоит и что делает, когда провайдер не отвечает.
Пять задач AI-разработчика на примерах
Дальше — пять типовых задач. Где есть мой опыт, я пишу о нём; остальное — сценарии и ссылки на официальную документацию.
1. Подключить модель через API
Первое, с чем сталкивается AI-разработчик, — у каждого провайдера свой API. У меня в плагине их шесть, и снаружи это одна кнопка «сгенерировать», а внутри у каждого провайдера свои правила: способ авторизации, формат сообщений, ограничения на файлы. Например, Files API у GigaChat не принимает картинки в WebP, поэтому плагин перед отправкой делает временную копию в JPEG. А модель GigaChat 3 Ultra доступна только на новом общем адресе API api.giga.chat — со старого её не вызвать.
Отсюда первое правило: провайдеры прячут за общим интерфейсом внутри своего кода, а все различия держат в одном месте. Тогда замена модели — правка настройки, а не переписывание продукта. Помогает и то, что многие API похожи: DeepSeek, например, прямо пишет, что его API совместим с форматами OpenAI и Anthropic.
Второе правило — просить у модели строгий формат там, где ответ читает программа, а не человек. В документации OpenAI о Structured Outputs сказано, что в этом режиме модель всегда отвечает по заданной JSON-схеме, а обычный режим JSON гарантирует только корректный JSON, но не соответствие схеме.
2. Дать модели свои данные: RAG
Модель не знает ваших цен, договоров и статей базы знаний, и это вторая задача, которую AI-разработчик решает почти в каждом проекте. RAG решает её так: перед ответом система находит нужные фрагменты документов и кладёт их в запрос вместе с вопросом. Для поиска по смыслу тексты превращают в эмбеддинги — как это работает, я объяснял в статье про эмбеддинги простыми словами.
Модель не знает документов, цен и регламентов конкретной компании — их нужно ей показывать в момент вопроса. Для этого AI-разработчик собирает RAG: режет документы на фрагменты, считает для них эмбеддинги, складывает в векторную базу и перед ответом подкладывает модели самые близкие по смыслу куски. Самое трудное здесь не код, а качество поиска: нарезка, которая не отрывает оговорки от правил, гибридный поиск по смыслу и точным словам и проверка на наборе реальных вопросов — включая те, на которые ответа в базе нет.
Большинство ошибок RAG — ошибки поиска, а не модели: найден не тот фрагмент, и модель уверенно отвечает по нему. Anthropic в посте о Contextual Retrieval показала, что если добавить к каждому фрагменту короткое пояснение и совместить поиск по смыслу с поиском по словам, неудачных поисков становится на 49% меньше, а с переранжированием — на 67%. Почему модель без нужных данных начинает выдумывать, разобрано в статье о том, почему нейросеть выдумывает факты.
3. Собрать агента
Агент — это модель, которой AI-разработчик дал инструменты: функции, которые она может вызвать сама, когда решит, что они нужны. В документации Anthropic это называется tool use: модель смотрит на запрос и описание инструмента и сама решает, вызвать ли его. Подробно о том, где агенты полезны бизнесу, — в статье про ИИ-агентов для бизнеса.
В моём плагине есть агент брифа. Он ведёт с пользователем диалог: уточняет тему, аудиторию и ключи, а в конце собирает задание на статью. В таких агентах самое трудное — не код, а поведение: агент должен задавать вопросы по делу, не зацикливаться и честно говорить, чего не знает.
Хороший ориентир — пост Anthropic Building effective agents. Его главная мысль: самые удачные решения строили не на сложных фреймворках, а на простых составных шаблонах, и начинать стоит с прямых вызовов API. Для подключения инструментов есть открытый стандарт MCP — его поддерживают Claude, ChatGPT, VS Code, Cursor и другие приложения.
4. Проверить качество ответов
Это задача, без которой AI-разработчик превращается в человека, который «попробовал — вроде работает». Для этого агента у меня есть автотесты диалогов: набор сценариев, которые прогоняются автоматически и показывают, что агент спросил и что собрал. Эталонная модель в этих тестах — DeepSeek V4 Flash; с 17 октября 2026 года DeepSeek отвечает на это имя новой версией, V4.1 Flash. gpt-4o-mini на тех же сценариях заметно слабее.
Самый показательный прогон был в сентябре 2026 года: я проверял, может ли российская модель стать мозгом агента брифа. Из пяти моделей — YandexGPT Lite, YandexGPT, GigaChat-2, GigaChat-2-Pro и GigaChat-2-Max — порог прошла только GigaChat-2-Max, и то с оговорками: она справилась примерно с половиной сценариев, а запрос к ней стоил примерно в 20 раз дороже, чем к DeepSeek.
- YandexGPT на трети или половине вызовов отказывалась отвечать фразой «Я не могу обсуждать эту тему…». Причина оказалась в объёме правил в системном промпте, а не в каком-то слове: если убрать любые 8 строк, модель отвечала.
- GigaChat-2 сообщала о работе, которой не делала.
- Итог: для генерации планов и статей российские модели в плагине отключены. GigaChat оставлен для «Волшебной палочки», коротких инструментов и описаний картинок для alt.
Такие вещи видны только на полном наборе сценариев: отказ на трети вызовов легко пропустить, если вручную проверить пару диалогов. Anthropic в руководстве по оценке качества советует то же: лучше много вопросов с автоматической проверкой, чем несколько вопросов, проверенных вручную. OpenAI в своих рекомендациях прямо называет ошибкой оценку по ощущению «вроде работает». При этом сам сервис Evals на платформе OpenAI закрывают: с 31 октября 2026 года он только для чтения, а 30 ноября отключается. Держите тесты у себя в репозитории, а не в чужом облаке.
Один тест в таком наборе может выглядеть так:
{
  "id": "delivery-07",
  "question": "Успеете доставить в Тверь к пятнице?",
  "context": "faq/delivery.md",
  "must_contain": ["2–4 рабочих дня"],
  "must_not_contain": ["гарантируем", "точно успеем"],
  "max_cost_usd": 0.002
}
5. Посчитать стоимость
Последняя задача — деньги, и здесь AI-разработчик отвечает за цифры, которые увидит бухгалтерия. Провайдеры берут деньги за токены — входные, то есть ваш промпт с документами, и выходные, то есть ответ. Выход обычно в несколько раз дороже входа. Как модель меряет текст токенами, я разбирал в статье про токены в нейросети. Посчитаем запрос на 3 000 токенов входа и 1 000 токенов выхода по ценам на октябрь 2026 года:
| Модель | Вход / выход, $ за 1 млн токенов | Один запрос | 10 000 запросов |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 / 0,50 | $0,0008 | $8 |
| DeepSeek Flash, часы пик | 0,30 / 1,20 | $0,0021 | $21 |
| Claude Sonnet 5.5 | 2 / 10 | $0,016 | $160 |
| Claude Opus 5.5 | 4 / 20 | $0,032 | $320 |
Цены — по странице цен Anthropic и странице цен DeepSeek. У DeepSeek вне часов пик всё вдвое дешевле. Разница между краями таблицы — в сорок раз, и выбор модели под задачу экономит больше, чем любая оптимизация промпта.
Второй рычаг — кэширование: если начало запроса повторяется, например одинаковый системный промпт и база правил, провайдер берёт за него меньше. У Anthropic чтение из кэша стоит 0,1 от цены входа, а у Opus 5.5 и Sonnet 5.5 — 0,05. Поэтому неизменную часть запроса держат в начале, а меняющуюся — в конце.
Навыки и стек AI-разработчика
Ниже — что нужно знать, чтобы закрывать все пять задач. Это не список «выучить до собеседования», а карта: какие-то пункты вы уже знаете, какие-то освоите на первом проекте.
| Область | Что знать | Зачем |
|---|---|---|
| Язык программирования | Python или TypeScript и JavaScript; официальные SDK для них есть и у Anthropic, и у OpenAI, у Anthropic — ещё и для PHP | Писать сам сервис, а не только промпты |
| Веб и данные | HTTP, JSON, базы данных, очереди, повторы при сбоях | Провайдеры отвечают с задержками и иногда падают |
| API моделей | Вызов инструментов, строгий формат ответа, потоковые ответы, кэш | Из этого собирается любой продукт на модели |
| Поиск | Эмбеддинги, векторные базы, поиск по словам, переранжирование | RAG и работа с документами |
| Оценка качества | Наборы тестов, автоматические проверки, сравнение моделей | Понимать, стало лучше или хуже |
| Безопасность | Внедрение команд через текст, права агента, секреты | Агент не должен делать то, чего не просили |
| Закон о данных | 152-ФЗ: локализация и трансграничная передача | Что можно отправлять зарубежному провайдеру |
О безопасности стоит сказать отдельно. Агент с доступом к почте, базе или файловой системе может выполнить команду, спрятанную в тексте письма или документа. Чем больше прав, тем дороже ошибка — подробнее в статье о том, чем опасен ИИ-агент с полным доступом.
С законом то же. Часть 5 статьи 18 закона 152-ФЗ требует, чтобы запись, хранение и обновление персональных данных россиян шли в базах на территории России. А до начала трансграничной передачи оператор обязан отдельно уведомить Роскомнадзор — это часть 3 статьи 12 закона 152-ФЗ. Поэтому имена, телефоны и адреса клиентов в запросах к зарубежным моделям обезличивают или выбирают провайдера, который обрабатывает данные в России.
Что не обязательно на старте
Глубокая математика и обучение моделей с нуля нужны ML-инженеру, а не AI-разработчику. Но понимать, как модель устроена снаружи, нужно обязательно: что такое токены и окно контекста, почему одна и та же просьба даёт разные ответы, почему модель уверенно ошибается. Без этого не получится ни правильно составить запрос, ни объяснить заказчику, почему бот иногда отвечает не то.
Сколько зарабатывает AI-разработчик
Честный ответ: отдельной открытой статистики по профессии AI-разработчик я не нашёл ни у hh.ru, ни у Хабр Карьеры. Есть цифры по соседним профилям, и по ним можно ориентироваться.
| Источник | Что измерено | Цифра | Дата |
|---|---|---|---|
| Карьерная платформа hh.ru | ML-инженер, зарплаты в вакансиях на hh.ru | от 120 000 до 370 000 ₽ в месяц | статья от 07.10.2026 |
| Хабр Карьера | Python-разработчики, медиана по анкетам | 243 000 ₽, рост 6% за полгода | первое полугодие 2026 |
| Хабр Карьера | Все IT-специалисты, медиана по 45 226 анкетам | 191 000 ₽ | первое полугодие 2026 |
Данные hh.ru взяты из статьи о профессиях в сфере ИИ, данные Хабр Карьеры — из отчёта о зарплатах за первое полугодие 2026 года. Учтите разницу: hh.ru считает по зарплатам, которые компании пишут в вакансиях, а Хабр Карьера — по окладам, которые специалисты сами указали в калькуляторе.
О спросе hh.ru пишет так: в январе и феврале 2026 года работодатели разместили 10 777 вакансий с требованием владеть ИИ против 9 378 за те же месяцы 2025 года. Это рост примерно на 15%, а доля таких вакансий выросла с 0,5% до 0,8% от всех. Но это вакансии, где ИИ — один из навыков, а не только вакансии AI-разработчиков.
Как стать AI-разработчиком: 6 шагов
- Программирование. Если вы не пишете код, начните с Python или JavaScript и доведите до уровня, когда можете написать небольшой сервис с базой данных. Агенты для кода ускоряют учёбу, но не заменяют понимание.
- Первый вызов API. Получите ключ у провайдера, отправьте запрос из кода, разберите ответ. Затем попросите строгий JSON по схеме и научитесь обрабатывать ошибки и таймауты.
- Поиск по своим документам. Возьмите 30–50 страниц реального текста — правила, инструкцию, FAQ — и соберите по ним простой RAG. Проверьте, на какие вопросы он отвечает неправильно и почему.
- Агент с двумя-тремя инструментами. Например, поиск по базе и создание задачи в трекере. Ограничьте права и записывайте в журнал каждый вызов.
- Тесты и стоимость. Сделайте 20–30 тестовых сценариев, прогоните на двух-трёх моделях и сведите в таблицу качество и цену.
- Публикация. Выложите проект в репозиторий с README: что делает, как проверено, сколько стоит месяц работы. Это и есть заявка на вакансию.
Портфолио AI-разработчика: 5 проектов для старта
Работодателю или заказчику мало увидеть, что бот AI-разработчика «отвечает». Им важно, что вы умеете измерять качество и цену. Поэтому каждый проект в портфолио стоит сопровождать цифрами из своих тестов.
| Проект | Что он показывает | Чем доказать |
|---|---|---|
| Консультант по базе FAQ | RAG, ответы со ссылкой на источник | Доля верных ответов на тестовых вопросах |
| Классификатор заявок | Строгий формат ответа, обработка ошибок | Точность на размеченной выборке |
| Агент для CRM или календаря | Вызов инструментов, ограничения прав | Журнал вызовов и сценарии отказа |
| Сравнение трёх моделей | Оценка качества и учёт стоимости | Таблица: качество, цена, время ответа |
| Плагин или интеграция для CMS | Продукт, которым пользуются люди | Установки, отзывы, обращения в поддержку |
Последний пункт — самый сильный, потому что это уже продукт, а не учебная задача. Мой пример — плагин SmartyPress AI Engine, который пишет и правит тексты нейросетью прямо в WordPress. Как он устроен и какие задачи решает — в кейсе в портфолио.
Ошибки начинающих AI-разработчиков
- Проверка на глаз. Пять удачных диалогов ничего не доказывают: модель, которая отказывает на трети вызовов, как YandexGPT в моих тестах, при ручной проверке может выглядеть исправной.
- Огромный системный промпт. Правила копятся, и в какой-то момент модель начинает отказываться или путаться. История с YandexGPT показала: дело может быть в объёме, а не в содержании.
- Вера отчёту модели. Модель может написать «сделано», ничего не сделав, как это было с GigaChat-2. Проверяйте результат по факту: файл, запись в базе, ответ API.
- Одна модель на всё. Для коротких правок текста и описаний картинок хватает лёгкой модели, сильная нужна там, где модель рассуждает и ведёт диалог.
- Цена после запуска. Посчитайте стоимость запроса и месяца до того, как отдадите продукт людям.
- Персональные данные в зарубежный API. Сначала разберитесь с 152-ФЗ, потом отправляйте.
Если хотите разобрать типовые ошибки агентов глубже, загляните в статью о том, почему ИИ-агент ошибается.
Где учиться на AI-разработчика
Самые точные учебники — документация провайдеров, потому что она меняется вместе с моделями. Начните с документации Anthropic по вызову инструментов, кэшированию и оценке качества, гайдов OpenAI по строгому формату ответов и вызову функций, документации DeepSeek и сайта стандарта MCP. Там же есть примеры кода, которые можно запускать сразу.
Если удобнее учиться с наставником на своём проекте, у меня есть личное обучение созданию сайтов, ботов и сервисов с ИИ.
Частые вопросы
Можно ли стать AI-разработчиком без опыта программирования? Можно, но путь пройдёт через программирование. Собрать прототип с помощью агента получится и без него. А вот поддерживать сервис, искать причину ошибки и считать стоимость без умения читать код не выйдет.
Чем разработчик AI-агентов отличается от AI-разработчика? Это одна и та же профессия с упором на агентов: инструменты, многошаговые задачи, права и журналы вызовов. На практике AI-разработчик делает и агентов, и всё остальное.
Какие вакансии искать AI-разработчику? Ищите сразу по нескольким названиям: «AI-разработчик», «AI-инженер», «LLM-инженер», «разработчик AI-агентов», а также вакансии Python- и бэкенд-разработчиков, где в требованиях есть работа с API моделей, RAG или агентами. Читайте не название, а обязанности: если там обучение моделей и метрики точности, это работа ML-инженера.
Нужен ли AI-разработчику английский? Читать техническую документацию — да. Документация провайдеров и стандарта MCP — в первую очередь на английском, и новое появляется там раньше, чем в переводах и курсах. Говорить свободно для старта не обязательно.
Можно ли работать только с российскими моделями? Для части задач — да. У GigaChat и YandexGPT есть API, и на коротких задачах вроде правки абзаца или подписи к картинке их хватает. Но для ведения диалога и длинной генерации ни одна из пяти протестированных мной российских моделей в сентябре 2026 года не прошла порог уверенно.
Заменит ли ИИ самих AI-разработчиков? Агенты для кода берут на себя много рутины — я сам пишу плагины в Claude Code, — но решать, что строить, как проверять качество и за что платить, по-прежнему людям. О том, какие профессии ИИ меняет первыми, — в статье о том, кого ИИ заменит первым.
Коротко
- AI-разработчик строит продукты на готовых моделях: интеграции с API, RAG, агенты, тесты качества и учёт стоимости. Модели с нуля он не обучает.
- От ML-инженера он отличается тем, что делает сервис, а не модель, а от вайбкодера — тем, что отвечает за качество и цену на тысячах реальных запросов.
- Главный навык AI-разработчика — проверка: без набора тестов не видно, что смена модели или промпта сломала поведение.
- Отдельной открытой статистики зарплат по профессии нет; ориентиры — ML-инженер на hh.ru от 120 000 до 370 000 ₽ и медиана Python-разработчиков 243 000 ₽ у Хабр Карьеры.
- Портфолио сильнее всего, когда в нём есть цифры: доля верных ответов, цена запроса и месяца, сравнение моделей.


